
Когда компания решает узнать, сколько стоит внедрить ИИ в бизнес, первый же запрос к подрядчикам приносит разброс в десятки раз. Одни обещают собрать умного помощника за пару вечеров и скромный бюджет, другие выставляют многомиллионную смету на перестройку всей ИТ-инфраструктуры. Проблема не только в аппетитах исполнителей: под «внедрением ИИ» заказчики часто понимают совершенно разные по архитектуре задачи — от простого виджета для ответов по PDF-инструкции до автономной системы, которая обменивается данными с учётной базой и управляет заявками в CRM.
Чтобы не переплатить за избыточную разработку и не застрять с неработающим прототипом, стоимость внедрения ИИ нужно делить на три отдельные части: разовую сборку и интеграцию, ежемесячное потребление ресурсов и затраты на подготовку собственных данных. Если у вас уже есть сформулированная задача и нужно сразу прикинуть бюджет под конкретный проект, воспользуйтесь калькулятором и посмотрите актуальные тарифные пакеты на странице цен и расчёта стоимости. А ниже подробно разберём, из каких узлов складывается смета, сколько денег уходит на содержание системы после запуска и как посчитать реальную окупаемость до подписания договора.
От чего зависит стоимость
Оценка любого проекта с генеративными моделями упирается не столько в выбор самой нейросети, сколько в окружение, в котором ей предстоит работать. Языковая модель сама по себе — это только вычислительное ядро, способное обрабатывать и генерировать текст или вызывать заданные функции. Всё, что делает её полезным корпоративным инструментом, приходится достраивать вокруг неё программно.
Глубина интеграции с внутренними системами
Самый дешёвый в разработке вариант — изолированный контур. Сотрудник заходит в веб-интерфейс, загружает туда документ или пишет вопрос, получает сгенерированный ответ и сам переносит результат в рабочую программу. Как только появляется требование, чтобы система сама забирала данные из CRM, проверяла остатки на складе или создавала черновики в 1С, смета растёт.
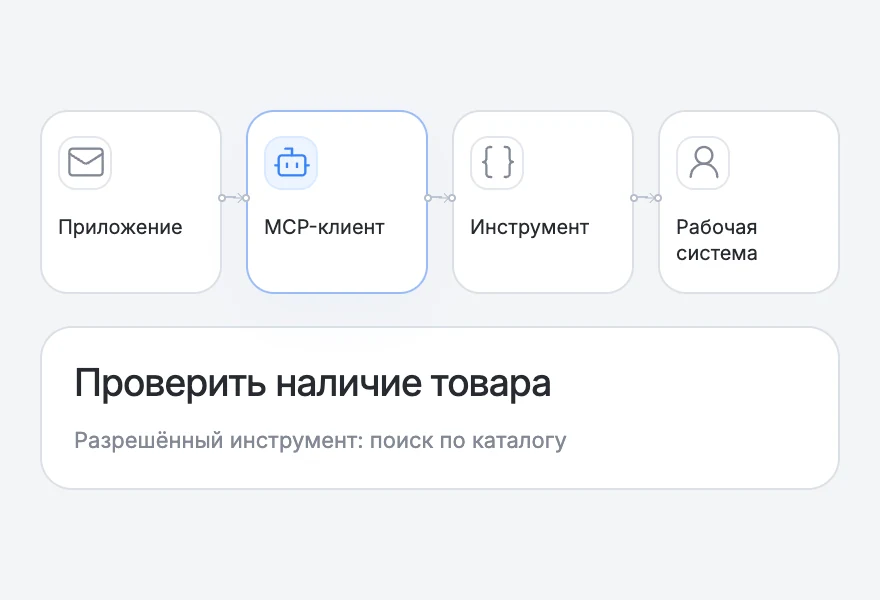
Связать языковую модель с корпоративным софтом можно разными способами. Например, открытый протокол Model Context Protocol (MCP) стандартизирует архитектуру, связывающую хост-приложение, клиент и сервер, через который модель получает доступ к внешним инструментам (tools), источникам данных (resources) и шаблонам (prompts) по транспорту stdio или Streamable HTTP. Но сам по себе протокол не создаёт готовую интеграцию с той же 1С: инженерам всё равно нужно реализовать сам серверный коннектор, описать методы прикладной системы, настроить обработку ошибок и разграничить права доступа, чтобы модель не получила полномочий менять закрытые периоды или чужие карточки контрагентов. Каждая нестандартная или кастомизированная конфигурация учётной системы увеличивает часы разработки и тестирования.
Качество корпоративных данных и устройство поиска (RAG)
Если бот или внутренний ассистент должен отвечать строго по регламентам, прайс-листам и технической документации компании, данные нельзя просто отправить в модель одним файлом при каждом запросе — это дорого, медленно и быстро упирается в ограничения контекста. Для таких задач строят архитектуру поисково-дополненной генерации (RAG).
Документы предварительно разбивают на смысловые фрагменты, превращают в числовые векторы (эмбеддинги) и сохраняют в специализированную СУБД — например, Qdrant. Согласно технической документации Qdrant, такая система разделяет сами векторы, полезную нагрузку с метаданными (payload), коллекции и индексы, а также позволяет сочетать векторный поиск с жёсткими фильтрами по атрибутам и полнотекстовым поиском. Настроить гибридный поиск с фильтрацией по артикулам, датам действия приказов или филиалам — заметно более трудоёмкая инженерная задача, чем просто сложить сырой текст в одно хранилище.
При этом важно понимать техническое ограничение: само по себе наличие математически близкого вектора в базе не доказывает истинность итогового ответа. RAG снижает риск выдумок модели, потому что ограничивает её контекст найденными фрагментами, но не гарантирует стопроцентной точности. Если в исходных регламентах компании есть противоречия, устаревшие таблицы или отсканированные вверх ногами страницы, большую часть бюджета съест не настройка Qdrant, а очистка и разметка документов, а также написание проверочных правил.
Канал коммуникации и требования платформ
Когда заказчики ищут, какова на разработку чат-бота стоимость, они часто предполагают, что перенос логики из одного мессенджера в другой делается нажатием одной кнопки. На практике у каждой площадки свои правила регистрации, лимиты и особенности интерфейса.
Например, согласно официальной документации платформы MAX (по данным на 2 ноября 2026 года), для создания чат-бота нельзя просто воспользоваться привычной механикой в духе Telegram BotFather. Разработка в MAX требует подключения к платформе партнёров и обязательной верификации профиля организации, индивидуального предпринимателя или самозанятого, являющихся резидентами РФ. Кроме того, действуют количественные ограничения: юрлица и ИП могут создать до 5 ботов, а самозанятые — не более 2, при этом токен управления выдаётся через веб-платформу или мини-приложение «MAX для бизнеса». Все эти платформенные условия — от согласования юридического профиля до адаптации кнопок и вебхуков под конкретный мессенджер — закладываются в смету на старте.
Среда размещения: облачные API или собственный контур
В России компании обычно выбирают из трёх вариантов инфраструктуры:
- Российские облачные платформы. Например, Yandex AI Studio (предоставляет генеративные модели, эмбеддинги, API и SDK, управление доступом, поиск по собственным данным и MCP Hub) или GigaChat API от Сбера (поддерживает работу с текстом, файлами, изображениями, вызов функций, структурированные данные и потоковую генерацию, имея отдельные регламенты подключения для физлиц и для ИП/юрлиц). Этот путь минимизирует капитальные затраты на старте: не нужно покупать видеокарты, а в облачных панелях есть отдельные настройки управления доступом и правила отключения логирования запросов.
- Зарубежные облачные API. Используются в проектах, где не передаются персональные данные граждан РФ и коммерчески чувствительная информация, либо через специализированную промежуточную инфраструктуру с учётом всех платёжных и юридических ограничений.
- Локальное развёртывание (On-premise). Открытые весовые модели запускаются на собственных или арендованных выделенных серверах с GPU внутри контура предприятия. Это резко поднимает порог входа за счёт стоимости оборудования и работы MLOps-инженеров.
Отдельно стоит оговорить популярное заблуждение: покупка локального сервера сама по себе не обеспечивает автоматического соблюдения требований 152-ФЗ «О персональных данных». Закон требует комплекса организационных и технических мер: моделирования угроз, категорирования, приказов о допуске, журналирования обращений и защиты контура. Локальная модель лишь исключает передачу данных стороннему облачному провайдеру, но всю правовую и инфраструктурную работу по защите информации компания должна провести самостоятельно.
Цены по типам решений
Так как единого рыночного стандарта цен на ИИ-разработку не существует, корректнее всего оценивать стоимость через состав работ для каждого класса систем. Если вам нужны состав работ и предварительная оценка эффекта под ваши объёмы, перейдите на страницу /ceny — в таблице ниже собрана структура того, за что именно платит заказчик в каждом сегменте, а также приведены подтверждённые публичные ориентиры отдельных игроков рынка.
| Тип решения | Что входит в базовую разработку и запуск | Что сильнее всего увеличивает бюджет | Публичные рыночные ориентиры и структура оценки |
|---|---|---|---|
| Клиентский чат-бот с ИИ | Настройка сценариев диалога, подключение к мессенджеру (например, верификация и выпуск токена в MAX) или виджету сайта, базовая промпт-инженерия, передача лидов в CRM. | Сложная маршрутизация на живых операторов, мультиязычность, загрузка и распознавание пользовательских файлов на лету, жёсткие фильтры безопасности ответов. | Оценивается по часам настройки сценариев, числу каналов и интеграций. Состав работ и запрос индивидуальной оценки — на /ceny. |
| Внутренний ассистент по базе знаний (RAG) | Парсинг документов, нарезка на фрагменты, генерация эмбеддингов, развёртывание векторной БД (например, Qdrant), настройка гибридного поиска с фильтрами по метаданным, интерфейс для сотрудников. | Неструктурированные исходники (сканы, сложные таблицы), ролевой доступ к разным папкам для разных отделов, регулярная автоматическая синхронизация с корпоративным порталом. | Смета складывается из подготовки датасета, настройки поискового ядра и веб-интерфейса. Расчёт под ваш объём документов доступен на /ceny. |
| ИИ-агент для бизнес-процессов | Оркестрация цепочек действий (например, на базе n8n или кастомного кода), подключение функции вызова внешних инструментов (function calling / MCP), интеграция по API с CRM/ERP, тестирование сценариев. | Нестандартные API старых корпоративных систем, необходимость встраивать шаг ручного подтверждения человеком перед критическими операциями, высокая нагрузка. | По данным публичного прайса подрядчика Goose AI (gooseai.ru/ceny/, проверено 2 ноября 2026), готовый агент из каталога со сценариями, интеграциями и тестированием стоит 150 000–300 000 ₽ (это предложение конкретного вендора, а не средняя цена рынка). Наши вилки — на /ceny. |
| Интеграция с 1С и обработка первички | Подключение профильных сервисов (например, «1С:Распознавание первичных документов» для ТОРГ-12, УПД, счетов и актов) либо написание серверных коннекторов и MCP-серверов к методам прикладной базы. | Сильно дописанные нетиповые конфигурации 1С, сложная сверка номенклатуры с внутренним справочником, маршрутизация расхождений на бухгалтера. | Стоимость делится на лицензии/тарифы самого сервиса распознавания и часы программистов 1С/интеграторов. Подробная разбивка работ — на /ceny. |
| Локальное внедрение (On-premise) | Подбор и развёртывание открытой модели на GPU-сервере заказчика, квантизация, настройка инференс-сервера, балансировка нагрузки, закрытый контур без внешних облачных API. | Закупка или аренда мощных ускорителей, дообучение (fine-tuning) на специфическом корпоративном сленге, встраивание в контур информационной безопасности. | Наиболее капиталоёмкий формат: включает стоимость «железа» и работу MLOps-инженеров. Индивидуальный расчёт — на /ceny. |
Разбираясь, сколько стоит ИИ-агент по сравнению с обычным текстовым ботом, нужно смотреть на количество действий, которые система совершает во внешней среде. Обычный консультант только ищет текст и формулирует ответ. Агент же работает по циклу: анализирует входящее событие, выбирает нужный инструмент (например, запрашивает статус оплаты по API), считывает ответ системы, принимает решение о следующем шаге и записывает результат обратно в базу. Каждая такая развилка требует отдельной проработки исключений и тщательного тестирования на тестовом стенде, чтобы сбой стороннего сервиса не привёл к зацикливанию сценария и потере клиентских данных.
То же самое касается автоматизации бухгалтерии и документооборота. На рынке есть зрелые специализированные решения — например, официальный сервис «1С:Распознавание первичных документов» (1С:РПД), который умеет обрабатывать счета, накладные ТОРГ-12, акты, счета-фактуры, УПД, УКД и кассовые чеки. Но даже при использовании готового штатного инструмента процесс строится по строгой цепочке: загрузить файлы, распознать их, проверить результат человеком и только после этого создать документы в учётной базе. Обещать бизнесу полностью бесконтрольное автоматическое проведение первички без участия бухгалтера нельзя — цена ошибки в налоговом и бухгалтерском учёте несопоставима с экономией нескольких минут рабочего времени. Поэтому в смету грамотного внедрения всегда закладывается настройка удобного интерфейса верификации, где система подсвечивает сомнительные поля, а финальную кнопку нажимает сотрудник.
Ежемесячные расходы: токены, сервер, поддержка, с расчётом на примере
Разовая оплата разработки — это только входной билет. В отличие от классического скрипта на жёстких правилах, система с искусственным интеллектом расходует вычислительные ресурсы при каждом осмыслении текста. Чтобы бюджет проекта не стал неприятным сюрпризом через месяц после релиза, операционные затраты (OpEx) нужно просчитывать заранее.
Ежемесячная смета состоит из четырёх постоянных статей:
- Обращения к API языковых моделей и моделей эмбеддингов. В облачных платформах вроде Yandex AI Studio или GigaChat API оплата привязана к объёму обрабатываемого текста (количеству входных и выходных токенов) либо к выбранному тарифному пакету для юридических лиц. В стоимость каждого ответа входит не только короткий вопрос клиента и сгенерированный абзац, но и скрытый системный промпт с правилами поведения, история предыдущих реплик диалога и все фрагменты документов, которые поисковая система подтянула из векторной базы для контекста.
- Платформа оркестрации и автоматизации сценариев. Многие компании собирают логику агентов в визуальных средах автоматизации, таких как n8n. Здесь важно учитывать лицензионные и тарифные нюансы. Во-первых, n8n распространяется по fair-code лицензии, поэтому его нельзя безоговорочно называть полностью свободным ПО. Во-вторых, если выбирать облачную версию на официальном сайте
n8n.io/pricing/(проверено 2 ноября 2026 года), тариф Starter стоит 20 евро в месяц за 2 500 исполнений сценариев (workflow executions), а тариф Pro — 50 евро в месяц за 10 000 исполнений. Обратите внимание: эти суммы указаны как помесячный эквивалент при оплате сразу за год, а не при помесячном списании. Кроме того, в эту цену входят только сами прогоны сценариев внутри облака n8n — оплата API внешних нейросетей, дополнительная инфраструктура и работа интегратора считаются отдельно, а российским заказчикам перед выбором облачной версии необходимо отдельно проверить техническую и юридическую возможность оплаты зарубежного сервиса. При размещении n8n на собственном сервере (self-hosted) регулярные платежи смещаются в сторону аренды виртуальной машины и часов системного администратора. - Серверная инфраструктура и базы данных. Даже если сама нейросеть вызывается по облачному API, где-то должны крутиться бэкенд-приложение бота, база истории переписок, очередь задач и векторное хранилище (например, кластер Qdrant). Для небольших проектов достаточно стандартного облачного VPS, для высоконагруженных систем или локальных моделей требуется аренда выделенных серверов с профессиональными видеокартами.
- Инженерная поддержка и дообучение промптов. Бизнес не стоит на месте: меняются цены, выходят новые редакции договоров, клиенты начинают задавать неожиданные вопросы, а сторонние сервисы обновляют свои API. Без регулярного мониторинга логов диалогов качество ответов ассистента постепенно падает.
Расчёт ежемесячных расходов на условном примере
Чтобы показать механику расчёта, разберём условный учебный пример. Допустим, оптово-розничная компания запускает ИИ-ассистента для первой линии поддержки клиентов и помощи менеджерам по продажам. Все цифры нагрузки и расценок ниже взяты в качестве иллюстративной модели — в реальном проекте туда подставляются актуальные тарифы выбранного вами провайдера на день расчёта.
Исходные параметры условного сценария:
- В компанию поступает 3 000 обращений в месяц.
- В среднем один диалог состоит из 4 сообщений от пользователя и 4 ответов бота (итого 12 000 запросов к модели в месяц).
- При каждом запросе в модель передаётся системная инструкция, краткая история беседы и 3 найденных в Qdrant фрагмента из базы знаний — в среднем 2 000 входных токенов на один шаг.
- Ответ ассистента составляет в среднем 250 выходных токенов.
- Для маршрутизации и связи с CRM используется один сценарий автоматизации на каждое сообщение клиента (12 000 запусков сценария в месяц, плюс 3 000 фоновых операций обновления базы — всего 15 000 операций).
Как складывается ежемесячная калькуляция в этом условном примере:
- Вызовы языковой модели (LLM API).
- Входящий трафик за месяц: (24 млн).
- Исходящий трафик за месяц: (3 млн).
- Если принять условную расчётную ставку коммерческого облачного API за рублей на 1 млн входных токенов и рублей на 1 млн выходных (например, при условном ориентире 200 ₽ за 1 млн входных и 600 ₽ за 1 млн выходных токенов), затраты на генерацию составят: . Плюс около 200–400 ₽ уйдёт на генерацию эмбеддингов при обновлении документации (в сумме — условные 7 000 ₽).
- Хостинг базы данных и оркестратора.
- Компания решает не зависеть от зарубежных платежей и разворачивает оркестратор сценариев, бэкенд и векторную базу Qdrant на российском облачном сервере (VPS с достаточным объёмом оперативной памяти для хранения векторного индекса в RAM и резервным копированием). Аренда такой виртуальной инфраструктуры обходится в условные 6 000 ₽ в месяц.
- Сопровождение и корректировка базы знаний.
- Раз в неделю аналитик или инженер подрядчика просматривает диалоги, в которых бот не смог найти ответ или перевёл клиента на оператора, правит системный промпт и догружает новые прайсы (например, 6 часов работы специалиста в месяц по условной ставке 3 000 ₽/час = 18 000 ₽ в месяц).
Итог по условному примеру: обязательные эксплуатационные расходы на систему составят . Как видно из расчёта, сами нейросетевые токены при разумной архитектуре часто оказываются самой скромной строкой бюджета, тогда как основная доля регулярных затрат приходится на надёжную инфраструктуру и квалифицированный присмотр за качеством ответов.
Скрытые расходы
Когда проект выходит за рамки презентации и сталкивается с реальными сотрудниками и клиентами, всплывают затраты, которые редко вписываются в коммерческое предложение на этапе пресейла. Именно они чаще всего раздувают первоначальный бюджет в полтора-два раза.
Приведение в порядок корпоративной документации
Почти в каждой компании уверены, что у них «есть готовая база знаний». На деле при аудите обнаруживается папка на сетевом диске, где лежат регламенты 2019 года вперемешку с новыми приказами, таблицы Excel с объединёнными ячейками и голосовые сообщения руководителя в рабочем чате. Языковая модель не умеет угадывать, какой из двух противоречащих друг другу файлов считать актуальным. Прежде чем загружать тексты в индекс, кому-то внутри компании придётся глазами вычитать сотни страниц, удалить мусор и переписать двусмысленные формулировки. Это десятки часов рабочего времени ваших самых компетентных профильных специалистов — РОПов, главных технологов или юристов.
Борьба с галлюцинациями и тестирование краевых сценариев
Даже при использовании гибридного поиска в векторной БД система может выдать неточный ответ, если вопрос пользователя сформулирован косвенно или требует сопоставления фактов из разных концов длинного документа. Чтобы снизить этот риск, приходится собирать проверочный набор данных (golden dataset) из 100–200 реальных каверзных вопросов с эталонными ответами и прогонять систему через него после каждого изменения промпта или настроек поиска. Пропуски этого этапа приводят к тому, что клиентский бот начинает обещать несуществующие скидки или соглашаться с претензиями, которые противоречат оферте компании.
Сопротивление сотрудников и затраты на обучение
Внутренний ИИ-ассистент или система обработки первички не принесут ни рубля выгоды, если персонал продолжит работать по старинке. Менеджеры часто боятся, что автоматизация приведёт к сокращениям или пересмотру KPI, а бухгалтеры не доверяют автоматическому распознаванию после первой же мелкой опечатки в сложной накладной. В бюджет внедрения приходится закладывать написание коротких видеоинструкций, проведение установочных встреч, назначение ответственного внутри отдела и время руководителей на контроль того, чтобы новым инструментом действительно пользовались.
Юридическая и организационная обвязка
Если через систему проходят анкеты клиентов, резюме соискателей или договоры с физическими лицами, подключается юридический отдел и служба информационной безопасности. Потребуется проверить договоры с облачными провайдерами (например, изучить условия хранения данных и отключения логирования в документации выбранной российской платформы), обновить политику обработки персональных данных на сайте, добавить согласия для пользователей в интерфейс чат-бота и настроить маскирование чувствительных полей перед отправкой в лог-файлы.
Как посчитать окупаемость
Оценивать экономический эффект от внедрения ИИ имеет смысл только через время сотрудников, стоимость обработки одной операции или снижение числа потерь на конкретном участке воронки. Абстрактные обещания «повысить продуктивность бизнеса на 40%» не позволяют защитить бюджет перед финансовым директором.
Базовая формула расчёта
Для практической оценки используют расчёт срока окупаемости () и возврата на инвестиции () за первый год работы системы:
Где:
- — чистая ежемесячная экономия (выгода) после запуска системы в рублях;
- — среднее время (в часах), которое сотрудник тратил на одну операцию вручную до автоматизации;
- — среднее время (в часах), которое сотрудник тратит на проверку и доработку результата после внедрения ИИ (это значение почти никогда не равно нулю!);
- — количество таких операций в месяц;
- — полная стоимость одного часа работы сотрудника для компании (оклад, премии, страховые взносы и накладные расходы, поделённые на рабочие часы);
- — ежемесячные расходы на работу самой ИИ-системы (токены, сервер, лицензии, техподдержка).
Срок окупаемости в месяцах рассчитывается как отношение разовых капитальных затрат на разработку и внедрение () к чистой ежемесячной выгоде:
А годовой в процентах показывает, сколько принесёт проект за 12 месяцев с учётом стартовых вложений:
Условный пример расчёта окупаемости
Разберём расчёт на условном сценарии (все цифры в примере учебные и предназначены для демонстрации методики, а не как гарантия результата).
Предположим, торговая компания получает 4 000 типовых запросов от закупщиков и дилеров в месяц: подобрать аналоги товаров по артикулу, проверить совместимость деталей по техническим паспортам и выставить предварительный расчёт.
- Ситуация до внедрения (). Инженер-консультант тратит на поиск информации по PDF-каталогам и сверку позиций в среднем 12 минут (0,2 часа) на одну заявку. На 4 000 заявок уходит (это полная загрузка 5 штатных специалистов).
- Стоимость часа работы (). Полные затраты компании на одного инженера с налогами и рабочим местом составляют 120 000 ₽ в месяц при норме 160 часов, то есть . Ежемесячный фонд рабочего времени на эту рутину — .
- Ситуация после внедрения (). Компания внедряет ИИ-ассистента с гибридным поиском по каталогам и черновой сборкой КП. Система не увольняет инженеров и не отправляет сложные технические расчёты клиенту вслепую: она мгновенно находит нужные страницы паспортов, сопоставляет характеристики и формирует черновик ответа. Инженеру остаётся проверить подобранные позиции и нажать кнопку отправки — на это уходит 3 минуты (0,05 часа) вместо 12.
- Экономия времени. На 4 000 заявок теперь тратится вместо 800. Высвобождается 600 рабочих часов в месяц, что в денежном эквиваленте равно . Освободившееся время сотрудники направляют на обработку новых входящих лидов и сложные проектные продажи, без необходимости нанимать новых людей в штат при росте оборота.
- Учёт расходов на ИИ. Допустим, разовая разработка и интеграция системы с учётом разметки каталогов () обошлась компании в условные 480 000 ₽, а ежемесячное содержание серверов, API и поддержка () требуют 40 000 ₽ в месяц.
- Итоговые показатели:
- Чистая ежемесячная выгода (): .
- Расчётный срок окупаемости (): (с учётом месяца на раскатку и обучение персонала — около 2–2,5 месяцев с момента запуска в промышленную эксплуатацию).
Важная оговорка: эта математика сходится только тогда, когда высвобожденные 600 часов действительно конвертируются в деньги — например, компания отказывается от открытия трёх новых вакансий при расширении отдела, убирает оплату сверхурочных или за счёт ускорения ответа с 4 часов до 10 минут увеличивает конверсию из заявки в оплаченный счёт. Если же сотрудники просто начинают пить больше кофе при прежнем объёме продаж, финансовой окупаемости на счетах компании не возникнет.
Как снизить стоимость: начать с прототипа
Главная финансовая ошибка при внедрении ИИ — пытаться сразу спроектировать и оплатить огромную систему, охватывающую все отделы, мессенджеры и базы данных компании. В проектах с генеративными моделями всегда есть элемент неопределённости: заранее невозможно со стопроцентной точностью предсказать, насколько хорошо модель справится именно с вашими нетиповыми формулировками клиентов или запутанными таблицами поставщиков.
Чтобы не рисковать крупным бюджетом, разработку разумно разбить на этапы и начать с проверки гипотезы (Proof of Concept, PoC) или минимально жизнеспособного прототипа (MVP). Как это сокращает смету на старте:
- Ограничьте объём базы знаний одним сегментом. Не нужно оцифровывать и размечать архив за десять лет. Возьмите 20–30 самых востребованных документов или одну товарную категорию, на которую приходится половина вопросов клиентов, и соберите поисковый индекс только по ним.
- Отложите сложные двусторонние интеграции. Прежде чем писать промышленный коннектор к 1С или кастомный MCP-сервер с разграничением прав доступа, проверьте качество самой генерации и поиска в простом закрытом веб-интерфейсе или тестовом чате для сотрудников. Если модель с текущей структурой документов ошибается в подборе артикулов, ранняя автоматическая запись в учётную базу принесёт только вред.
- Используйте облачные API и готовые оркестраторы на этапе проверки. Покупать собственный сервер с дорогими видеокартами до того, как вы убедились в полезности системы, нерентабельно. Проверить логику сценария гораздо дешевле на облачных мощностях (используя обезличенные или тестовые данные, не попадающие под ограничения безопасности) и визуальных инструментах автоматизации. Когда процесс докажет свою экономическую эффективность и вы упрётесь в реальные объёмы трафика, архитектуру можно будет плавно перенести на выделенные серверы или переписать узкие места кодом.
- Оставьте человека в контуре принятия решений (Human-in-the-loop). Вместо того чтобы тратить сотни часов разработчиков на попытки довести точность автономного агента с 90% до 99,9%, сделайте его суфлёром для штатного сотрудника. Разработка ассистента, который готовит черновик ответа в CRM за две секунды и ждёт клика менеджера, стоит в разы дешевле полностью автономной системы, а бизнес-эффект даёт уже в первую неделю после запуска.
Нужна помощь с внедрением?
Если вы хотите понять, во сколько обойдётся решение вашей задачи и имеет ли смысл автоматизировать её с помощью нейросетей, начните с предварительной оценки. Мы разберём ваш процесс, подскажем, где можно обойтись готовыми сервисами и простым прототипом, а где потребуется полноценная интеграция, и посчитаем честную смету без скрытых платежей. Посмотреть состав работ, воспользоваться калькулятором и оставить заявку на расчёт проекта можно на странице наших цен и услуг.