Локальная нейросеть для компании
Если документы нельзя отправлять во внешний API, модель можно разместить в согласованном контуре. Подбираем способ запуска под данные, нагрузку и требования вашей команды.
Стоимость и сроки — после знакомства с задачей. Объём прототипа согласуем до начала работ.
Какие задачи решаем
Внутренние документы
Искать ответы в инструкциях и договорах, доступных конкретному сотруднику.
Закрытые данные
Обрабатывать разрешённые поля без обращения к внешней модели.
Связь с системами
Подключить каталог и отчёты через ограниченные инструменты и сервисные аккаунты.
Контроль эксплуатации
Управлять обновлениями, журналами и резервными копиями по правилам компании.
Как это работает

Схема первого сценария. Состав действий и права доступа уточняем под ваши системы.
Где разместить модель
| Вариант | Что получаете | Что проверить |
|---|---|---|
| Сервер компании | Управление инфраструктурой внутри компании | Оборудование, администрирование, резервирование |
| Выделенная инфраструктура | Ресурсы под согласованную нагрузку | Договор, доступы, размещение копий и журналов |
| Российское облако | Аренда ресурсов вместо покупки оборудования | Регион, поставщики, внешние вызовы, условия обработки |
Требования к серверу и стоимость владения
Универсальной конфигурации сервера для любой LLM нет. До покупки оборудования проверяем выбранную модель, длину контекста и нагрузку. Так можно избежать сервера, который дорог в содержании и не даёт нужной скорости.
| Параметр | От чего зависит | Как определяем |
|---|---|---|
| Память GPU и RAM | Размер модели, формат весов, длина запроса | Проверяем конкретную сборку на тестовом наборе |
| Производительность | Число одновременных запросов и допустимое ожидание | Измеряем задержку и пропускную способность |
| Диск и хранение | Объём документов, индексов, копий и журналов | Описываем состав и сроки хранения |
| Ежемесячные расходы | Аренда или амортизация, администрирование и поддержка | Считаем после выбора конфигурации |
Модели и дообучение
Рассматриваем модели с доступными весами, например семейства Qwen, DeepSeek и Llama. Для конкретной версии проверяем лицензию, требования и качество на ваших задачах. GigaChat и YandexGPT через API — отдельный вариант размещения, а не автоматически локальная установка.
Для работы с документами часто сначала достаточно поиска по базе и настройки запросов. Дообучение обсуждаем, если тест показывает устойчивую задачу, которую это может решить, и есть подходящие данные для обучения.
ИИ и 152-ФЗ: что нужно учесть
Локальное размещение само по себе не подтверждает соответствие 152-ФЗ. Нужно определить состав и цель обработки, правовое основание, доступы, сроки хранения и необходимые меры защиты.
В согласованной локальной схеме внешних вызовов модели нет. Но отдельно проверяем телеметрию, загрузку документов, резервные копии и обновления: название «локальная» не описывает весь маршрут данных.
152-ФЗ «О персональных данных»Какие задачи подходят для своего контура
Поиск по внутренним документам
Сотрудник задаёт вопрос по регламенту, договору или инструкции. Поиск отбирает доступные ему фрагменты, модель подготавливает ответ и показывает источник. Если документ недоступен пользователю или подтверждения нет, помощник не должен раскрывать содержание и придумывать ответ.
Разбор документов без внешнего API
Текст, таблицы и запросы обрабатываются внутри согласованной инфраструктуры. Сначала проверяем качество на ваших форматах, включая сканы. При этом локальное размещение само по себе не исправляет плохое распознавание и не заменяет программные проверки сумм и реквизитов.
Подготовка черновиков для команды
Модель помогает оформить письмо, резюме встречи или документ на основе разрешённых материалов. До запуска определяем, где хранится история, кто видит запросы и как долго остаются журналы. Для отправки подготовленного текста во внешние каналы можно оставить подтверждение сотрудника.
Что проверяем на вашем сервере
Нужны характеристики оборудования, ожидаемое число одновременных пользователей, длина документов и примеры запросов. На этой основе проверяем модель и режим работы. Покупать GPU до такой проверки необязательно: сначала можно провести ограниченный тест на согласованном оборудовании.
Проверяем качество ответов, задержку при рабочей нагрузке, использование памяти, права доступа и восстановление после перезапуска. Отдельно проверяем исходящие подключения и телеметрию компонентов. Обновления моделей и пакетов планируем отдельно: при установке они могут требовать доступ к внешним источникам, даже если рабочие запросы затем обрабатываются локально.
Как это сделали в проекте
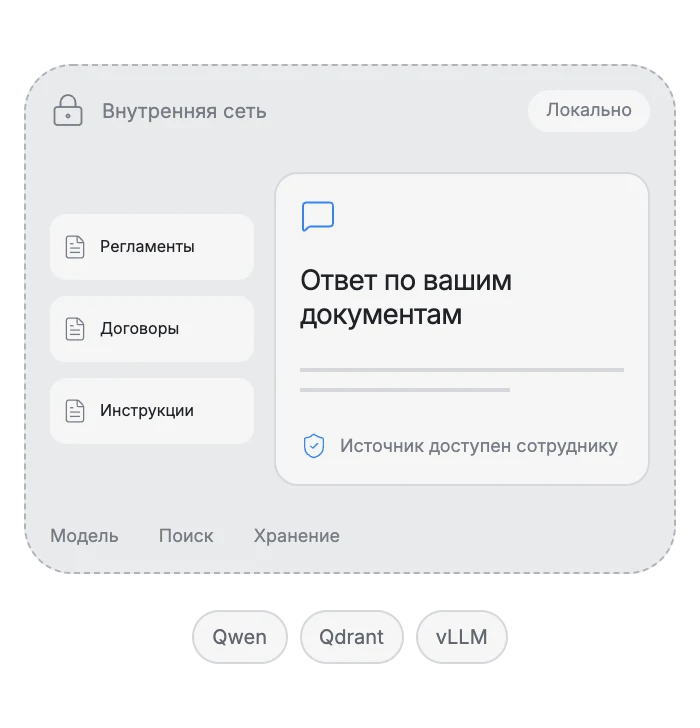
Поиск по документам в закрытом контуре
Развернули ассистента на инфраструктуре производственной компании. Поиск учитывает права сотрудников, ответы содержат ссылки на внутренние документы.
Читать кейсСтоимость и состав работ
Подбор и запуск модели на одном сервере с базовым интерфейсом.
Обычно 250 000 ₽–600 000 ₽В этом объёме
- Подбор модели под задачу и оборудование
- Развёртывание в согласованном контуре
- Проверка нагрузки, инструкция и передача
Отдельно
Покупка или аренда оборудования, полноценный RAG, SSO и отказоустойчивый кластер.
Точную сумму фиксируем после разбора задачи. Использование моделей, сервер, лицензии и поддержка оплачиваются отдельно по согласованным условиям.
Этапы и сроки
Разбираем задачу
Вы показываете процесс и примеры. Фиксируем, что меняем, какие данные нужны и как проверим результат.
Проверяем на прототипе
Собираем один сценарий. Вы пробуете его на согласованных примерах до большого внедрения.
Подключаем и проверяем
Настраиваем доступы, обмен данными, обработку ошибок и действия сотрудника в спорных случаях.
Передаём команде
Готовим инструкцию, показываем управление и согласуем поддержку. Сроки каждого этапа фиксируем в плане работ.
Интеграции и инструменты
Состав инструментов зависит от задачи и ограничений вашей компании. Не подключаем сервис только ради его названия в стеке.
Доступы и безопасность данных
Согласуем контур, состав внешних соединений и административные роли. Проверяем, что доступ к поиску и документам ограничен правами пользователя. Порядок резервного копирования и удаления данных входит в план запуска.
Российские модели через APIВопросы
Какой сервер нужен?
После выбора модели и нагрузки измерим требования к памяти и скорости. Для оценки нужны число пользователей, одновременные запросы, объём документов и допустимое ожидание ответа.
Локальная модель хуже облачной?
Зависит от задачи и ресурсов. Сравниваем ответы на одном наборе примеров и учитываем не только качество, но и задержку, стоимость и ограничения на данные.
Можно использовать ChatGPT и соблюдать 152-ФЗ?
Это нельзя определить по названию сервиса. Нужен разбор конкретных данных, целей и оснований обработки, условий поставщика и маршрута передачи. Если такой маршрут не подходит, рассматриваем другой способ размещения.
Сколько стоит развернуть LLM?
Отдельно считаем настройку, оборудование или аренду, интеграции и сопровождение. Сначала проверяем требования на тесте; цену сервера до этого не фиксируем.
Когда нужно дообучение?
Когда есть измеримая задача и подготовленный набор примеров, а поиск по документам и настройка запросов её не закрывают. Проверяем пользу дообучения на отдельной тестовой выборке.
Что нужно
посчитать?
Укажите решение, системы и нагрузку. Затем оставьте контакт здесь же — обсудим задачу и подготовим оценку.