
Визуальный конструктор n8n позволяет собрать прототип ИИ-агента за несколько часов: достаточно соединить триггер, узел языковой модели и пару внешних инструментов. Однако между демонстрационным ботом, который отвечает на вопросы по короткой инструкции, и промышленной автоматизацией бизнеса лежит дистанция в десятки инженерных и юридических ограничений. В реальной эксплуатации всплывают галлюцинации при вызове API, отсутствие готовых безопасных коннекторов к корпоративным базам, права доступа к документам в векторном поиске и требования 152-ФЗ к обработке персональных данных.
Разберем, как устроены связки n8n ai изнутри, когда агентная логика действительно оправдана, из чего складывается полная стоимость владения решением в российских реалиях и какие архитектурные барьеры нужно закрыть до запуска в рабочий контур.
Чем ИИ-агент в n8n отличается от обычного линейного сценария
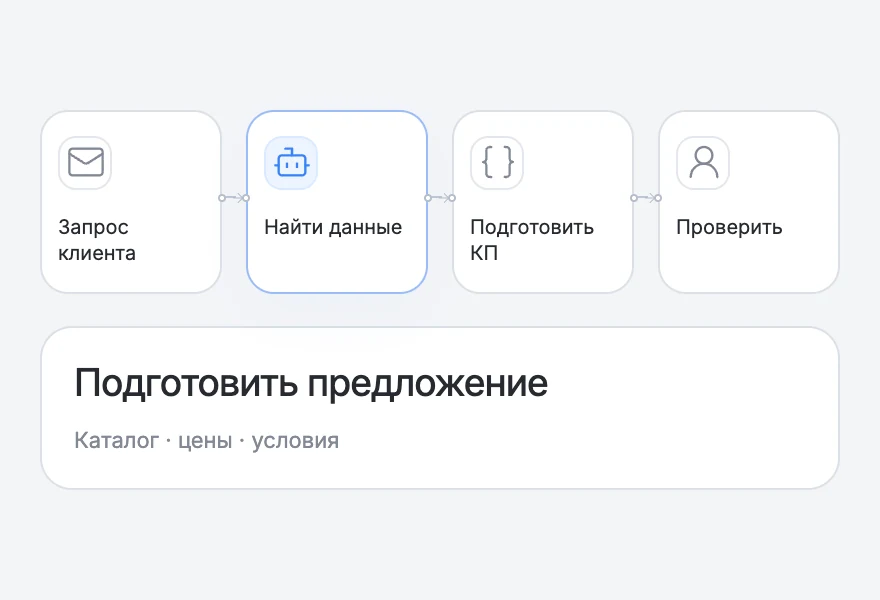
Обычный сценарий (workflow) в n8n работает по жестко заданному маршруту: пришло письмо — извлекли вложение — отправили файл в хранилище — записали строку в таблицу. Даже если внутри такого маршрута есть узел обращения к нейросети (например, для суммаризации текста письма), это еще не делает схему агентом. В детерминированной цепочке последовательность шагов всегда определяет разработчик с помощью условий If или Switch.
Полноценный n8n агент устроен иначе: порядок действий и набор вызываемых функций в момент выполнения определяет сама языковая модель. Согласно официальной документации n8n (проверено 3 ноября 2026 года), корневой узел AI Agent связывает языковую модель (Chat Model), блок памяти (Memory) и подключенные дочерние узлы-инструменты (Tool sub-nodes). Начиная с версии n8n 1.82.0 прежнее разделение на узкоспециализированные типы агентов (включая старый вариант выбора SQL Agent) устарело — современные сценарии строятся на едином механизме Tools Agent, где подключение хотя бы одного инструмента обязательно.
Когда в такой узел поступает задача, модель анализирует системный промпт, смотрит на описания доступных ей инструментов и сама решает:
- Нужно ли сейчас обратиться к внешнему источнику или достаточно ответить сразу.
- Какой именно инструмент вызвать и какие параметры передать в запрос.
- Достаточно ли полученных от инструмента данных или требуется сделать еще один вызов (например, уточнить статус клиента во второй системе).
Эта гибкость дает бизнесу возможность обрабатывать неструктурированные запросы со свободным текстом, но одновременно создает главный эксплуатационный риск: связка с языковой моделью сама по себе не гарантирует правильный порядок действий. Если описание инструмента составлено двусмысленно или модель неверно интерпретировала контекст, агент может вызвать не тот метод, передать некорректный идентификатор документа или уйти в цикл повторных запросов.
Показателен опыт крупных корпоративных внедрений, хотя и на других платформах: по сообщению компании «СберТех» от 23 сентября 2026 года о внедрении мультиагентной обработки клиентских обращений в Сбере (на базе Platform V Flow и GigaChat), проект начинался с замены CRM и автоматизации процессов с жесткой детерминированной логикой, и лишь затем, с 2025 года, к маршрутизации и обработке свободного текста подключили LLM. Этот принцип напрямую применим к архитектуре в n8n: все операции, которые можно описать строгими правилами, следует оставлять в обычных линейных узлах, передавая ИИ-агенту только участок разбора неструктурированных данных.
Архитектура узла AI Agent: из каких компонентов собирается схема
Чтобы собрать управляемого агента в n8n, недостаточно просто перетащить узел на холст. Рабочая схема опирается на четыре связанных контура.
1. Головная языковая модель (Chat Model)
Модель выступает диспетчером. От нее требуется не столько литературный стиль, сколько умение точно формировать вызовы функций (tool calling / function calling) и строго соблюдать заданную схему JSON.
В российских проектах выбор модели упирается в требования комплаенса и способы оплаты:
- Российские облачные API. По данным документации Yandex AI Studio и GigaChat API (проверено 2 ноября 2026 года), оба провайдера поддерживают работу с генеративными моделями по API, вызовы функций (tools) и создание эмбеддингов. Это позволяет подключать их к сценариям n8n без трансграничной передачи данных.
- Локальные модели в собственном контуре. Если корпоративная политика безопасности запрещает передачу данных во внешние облака, модель разворачивают на собственных или арендованных серверах с GPU (например, с использованием открытого движка инференса
llama.cpp, проверено 2 ноября 2026 года) и подключают к n8n по совместимому API.
2. Инструменты (Tools) и протокол MCP
Каждый инструмент для узла AI Agent в n8n — это отдельный сервис, база данных, HTTP-запрос или вызов дочернего сценария n8n (Sub-workflow). На практике самая надежная схема — выдавать агенту в качестве инструмента не прямой доступ к внешнему API, а вызов отдельного проверенного сценария n8n. Внутри этого дочернего сценария данные сначала проходят жесткую проверку (валидацию типов, проверку лимитов), и только после этого отправляются в учетную систему.
Отдельного внимания заслуживает развитие стандарта Model Context Protocol (MCP). Согласно официальной архитектурной документации MCP (проверено 2 ноября 2026 года), протокол связывает хост, клиент и сервер, позволяя серверам предоставлять модели инструменты (tools), ресурсы (resources) и шаблоны промптов (prompts) через транспорт stdio или Streamable HTTP. В Yandex AI Studio также представлен MCP Hub (проверено 2 ноября 2026 года). Однако важно понимать: сам по себе протокол MCP или встроенный инструмент n8n не создает готовую интеграцию с корпоративными базами — бизнесу всё равно нужно реализовать серверную логику, настроить права доступа и описать прикладные методы конечной системы.
3. Контур корпоративных знаний (RAG и векторные базы)
Если агент должен отвечать по внутренним регламентам, прайс-листам или каталогу товаров, к нему подключают векторную базу данных, например Qdrant. Здесь компании часто допускают критическую архитектурную ошибку: полагаются исключительно на векторную (смысловую) близость текста и просят модель в системном промпте «не показывать секретные документы или товары, которых нет на складе».
Такой подход не работает надежно. Как указано в официальной документации Qdrant (проверено 3 ноября 2026 года), векторный поиск необходимо сочетать с фильтрацией по метаданным (payload) и идентификаторам точек, используя для таких полей payload-индексы. Ограничения бизнеса — такие как наличие товара на складе, актуальный диапазон цен или роль пользователя в компании — нельзя заменять семантической близостью.
Практическое правило для RAG в n8n:
- Наличие похожего вектора в базе не доказывает истинность ответа — RAG снижает риск выдумок модели, но не гарантирует стопроцентную точность.
- Разграничение прав доступа к документам должна принудительно обеспечивать серверная логика сценария через жесткие фильтры
payloadдо того, как фрагменты текста попадут в контекст языковой модели. Само по себе добавление векторной БД задачу контроля доступа не решает.
4. Память диалога (Memory)
Узел памяти хранит историю переписки в рамках сессии, чтобы сотрудник или клиент мог задавать уточняющие вопросы. При проектировании нужно жестко ограничивать глубину окна памяти: если передавать в модель десятки длинных сообщений вместе с результатами вызовов инструментов, расход входных токенов будет расти лавинообразно на каждом следующем шаге диалога, а точность удержания инструкций — падать.
Где проходят реальные технические и бизнес-ограничения n8n
При переходе от экспериментов к промышленной эксплуатации автоматизации бизнес-процессов команда сталкивается с пятью жесткими барьерами, которые нельзя обойти только настройкой промпта.
Ограничение 1. Доступ к корпоративным БД и 1С
В n8n нельзя просто «дать агенту доступ к базе компании». Как подчеркивается в документации узла AI Agent в n8n (проверено 3 ноября 2026 года), устаревшие общие режимы SQL-агентов ушли в прошлое: для безопасного обращения к базам данных необходимо проектировать отдельные инструменты с узкими правами (например, только на чтение конкретных представлений с жестко заданными параметрами).
Еще нагляднее ситуация с учетными системами на платформе «1С:Предприятие». Официальная платформа 1С поддерживает создание произвольных HTTP-сервисов (проверено 2 ноября 2026 года): разработчик 1С должен самостоятельно задать шаблоны URL, написать обработчики HTTP-методов, настроить управление телом запроса, заголовками и кодами ответа. Готового «универсального коннектора любой нейросети к любой нетиповой конфигурации 1С» не существует. Чтобы агент в n8n мог безопасно проверить остатки или создать черновик счета, сначала потребуется работа программиста 1С по публикации защищенного прикладного API.
Ограничение 2. Российские корпоративные мессенджеры и каналы связи
Многочисленные инструкции по n8n строятся вокруг связки с Telegram через стандартного BotFather. Но если бизнес разворачивает внутренние или клиентские сценарии в российских сервисах, правила подключения меняются.
Например, согласно официальной документации платформы MAX по созданию чат-ботов (проверено 2 ноября 2026 года), перенести туда привычный процесс из Telegram нельзя. Для запуска бота в MAX необходимо подключиться к платформе партнеров и пройти верификацию профиля юридического лица, ИП или самозанятого — резидента РФ. При этом действуют количественные лимиты: организации и ИП могут создать до 5 ботов, самозанятые — до 2, а токен управления получается через веб-платформу или мини-приложение «MAX для бизнеса». Эти организационные шаги нужно закладывать в план проекта заранее.
Ограничение 3. Реалистичные показатели точности и необходимость участия человека (Human-in-the-loop)
Генеративный агент в n8n не способен без ошибок закрывать 100% сложных обращений. Это хорошо видно по подтвержденным рыночным внедрениям аналогичных систем с использованием RAG и языковых моделей.
Например, в опубликованном Yandex Cloud публичном кейсе компании «Инфосистемы Джет» (опубликован 13 февраля 2025 года, проверено 3 ноября 2026 года) приведены результаты полуторамесячного пилота системы поддержки, которая классифицирует запросы, ищет информацию по базе знаний (на базе Object Storage и OpenSearch) и формирует подсказки:
- автоматически обрабатывается до 30% обращений;
- точность классификации примерно по ста типам обращений составила 75%;
- корректность ответов языковой модели достигла до 80%.
При этом часть сгенерированных ответов в такой схеме обязательно передается сотруднику для проверки перед отправкой. (Отметим: это показатели конкретного пилотного проекта «Инфосистем Джет» и поставщика облачной платформы, а не универсальная гарантия для любого бизнеса или кейс «ЭйАй Бизнес»). При проектировании сценария в n8n необходимо закладывать точно такую же ветку ручной верификации: если уверенность классификатора ниже порога или вопрос касается финансовых условий, агент должен переводить задачу на живого оператора.
Ограничение 4. Работа с речью и звонками
Нередко через n8n пытаются собрать конвейер анализа звонков отдела продаж: забрать аудиофайл из телефонии, перевести в текст и отдать LLM-агенту для поиска ошибок менеджера. Похожий подход в качестве MVP описывала команда Сбера на Habr еще 26 июня 2024 года (проверено 3 ноября 2026 года): в тренажере для клиентских менеджеров расшифровки звонков получали через SaluteSpeech, а рекомендации по отработке возражений формировали с помощью GigaChat.
При сборке подобного конвейера в n8n нужно учитывать технические лимиты речевых сервисов. Так, по документации Yandex SpeechKit (проверено 2 ноября 2026 года), синхронный режим распознавания рассчитан только на одноканальное аудио длительностью до 30 секунд. Для полноценных многоканальных записей телефонных переговоров (до 4 часов) требуется выстраивать в n8n асинхронную схему с отправкой задания, ожиданием готовности и последующим забором результата. Кроме того, сама по себе текстовая расшифровка или сводка по ключевым словам (даже в специализированных системах вроде Yandex SpeechSense, проверено 2 ноября 2026 года) не является юридическим или управленческим доказательством виновности сотрудника, его эмоций или истинной причины ухода клиента — выводы нейросети требуют выборочного контроля качества.
Когда n8n-агент не нужен: готовые отраслевые альтернативы
Одна из главных задач руководителя перед стартом разработки — проверить, не пытается ли команда изобрести велосипед в n8n там, где на российском рынке уже есть зрелые специализированные продукты с предсказуемой ценой.
| Бизнес-задача | Попытка собрать своего агента в n8n | Готовое профильное решение (проверено 3 ноября 2026 г.) | Что выбрать на практике |
|---|---|---|---|
| Ввод первичных документов в 1С (счета, ТОРГ-12, УПД, УКД, акты, счета-фактуры, чеки) | Сборка сложного пайплайна OCR + LLM-парсинг + написание собственных HTTP-сервисов в 1С для записи объектов | Официальный сервис «1С:Распознавание первичных документов» (1С:РПД). Пакеты на год: 100 стр. — 600 ₽, 500 стр. — 2 500 ₽, 1 000 стр. — 4 500 ₽, 5 000 стр. — 21 000 ₽, 10 000 стр. — 40 000 ₽ (плюс тестовый пакет 250 стр.). Налоговый состав цен на странице не уточнен, лимит действует на пакет. | Для стандартной бухгалтерской первички выгоднее и надежнее штатный сервис 1С:РПД (с обязательной проверкой распознанных данных бухгалтером перед проведением). Свой агент в n8n нужен только для нестандартных договоров и специфических таблиц вне контура 1С. |
| Проверка условий и рисков участия в тендерах | Настройка парсеров закупочных площадок, выгрузка многостраничной документации и подача в LLM через n8n | Отраслевой сервис Контур.Закупки. Годовой тариф «Эксперт + ИИ» стоит 57 800 ₽/год (базовый «Эксперт» без ИИ-пакета — 46 400 ₽/год; налоговый состав цен и условия API уточняются отдельно). Включает ИИ-ассистента по условиям и рискам тендера и ИИ-отчеты. | Если компании нужен поиск и экспресс-анализ тендеров в одном окне, лицензия вендора закроет задачу быстрее разработки (хотя и не заменяет сверку заявки с актуальной документацией закупки). Сценарий в n8n оправдан, когда тендерный анализ нужно тесно связать с внутренним расчетом себестоимости в собственной ERP. |
| Массовая аналитика звонков контакт-центра | Самописная связка в n8n: скачивание записей + SpeechKit + промпты к LLM + сборка дашбордов | Готовый сервис Yandex SpeechSense. Пакеты на календарный месяц (с НДС): Basic (10 000 минут) — 45 000 ₽, Standard (30 000 минут) — 90 000 ₽, Advanced (100 000 минут) — 260 000 ₽. Включает рабочие места DataLens и статистику диалогов (обработка AI-ассистентом применяется к части записей по условиям пакета). | При небольших объемах или нестандартных сценариях точечная связка через n8n и SpeechKit обходится дешевле пакета речевой аналитики. При больших потоках звонков контакт-центра готовая витрина SpeechSense экономит месяцы работы аналитиков и BI-разработчиков. |
Экономика решения: сколько стоит сборка и эксплуатация n8n ai
Бюджет на внедрение ИИ-агента часто оценивают ошибочно, глядя только на стоимость подписки на облачный сервис автоматизации или цену тысячи токенов. В реальности смета состоит из пяти независимых статей расходов.
1. Платформа оркестрации (n8n vs альтернативы)
Согласно официальной документации n8n (проверено 2 ноября 2026 года), продукт распространяется по лицензии fair-code (его нельзя безоговорочно называть свободным ПО в классическом понимании Open Source). Компании доступны два пути:
- Облачная версия n8n. По данным официальной страницы тарифов
n8n.io/pricing(проверено 2 ноября 2026 года), при годовой оплате тариф Starter составляет эквивалент 20 евро в месяц за 2 500 исполнений сценариев (workflow executions), а тариф Pro — 50 евро в месяц за 10 000 исполнений. Важно: это эквивалент стоимости месяца при оплате сразу за год, а не помесячный тариф; кроме того, для российских юрлиц возможность оплаты зарубежного облака и требования локализации данных нужно проверять отдельно. - Собственное размещение (Self-hosted). Развертывание на собственном сервере снимает привязку к зарубежному облаку.
При этом архитектура тарификации n8n выгодно отличается от популярных облачных конкурентов вроде Make. По официальным правилам [make.com/pricing](https://make.com/pricing) (проверено 2 ноября 2026 года; бесплатный план включает 1 000 кредитов в месяц), базовой единицей расхода в Make являются кредиты (credits): почти каждое действие модуля внутри сценария списывает один кредит, а отдельные ИИ-функции — больше. В результате один сложный запуск агента с циклом из 15 шагов в Make израсходует десятки кредитов, тогда как в облачном n8n тарифицируется само исполнение workflow целиком (без учета стоимости внешних API).
2. Расходы на API языковых моделей и речевых сервисов
Если агент обращается к российским облачным моделям, затраты зависят от объема контекста (входных и выходных токенов) и выбранного провайдера.
- Yandex AI Studio. По официальному прайсу синхронного режима (проверено 3 ноября 2026 года, цены указаны в рублях с НДС за 1 000 токенов; кеширование и встроенные инструменты тарифицируются по отдельным правилам):
Alice AI LLM Flash: вход — 0,1 ₽, выход — 0,2 ₽;YandexGPT Lite: вход — 0,2 ₽, выход — 0,2 ₽;YandexGPT Pro 5.1: вход — 0,8 ₽, выход — 0,8 ₽.
- GigaChat API для бизнеса. По данным страницы тарифов для юрлиц (проверено 2 ноября 2026 года, обновление от 7 октября 2026 года), условия разделены по категориям клиентов:
- для действующих клиентов «СалютДевайсы» / «Салют для Бизнеса» в синхронном режиме pay-as-you-go стоимость за 1 000 токенов с НДС составляет:
GigaChat Lite— 0,065 ₽,GigaChat Pro— 0,5 ₽,GigaChat Max— 0,65 ₽ (при фактическом использовании действует минимальный платеж 600 ₽/месяц; если обращений не было, плата не взимается); - для новых клиентов с 1 сентября 2026 года подключение и оплата осуществляются через платформу cloud.ru — актуальные тарифы для нового подключения необходимо запрашивать непосредственно у cloud.ru, автоматически переносить на них архивные расценки нельзя.
- для действующих клиентов «СалютДевайсы» / «Салют для Бизнеса» в синхронном режиме pay-as-you-go стоимость за 1 000 токенов с НДС составляет:
Условный расчет № 1 (обработка текстовых заявок):
Допустим, ваш агент в n8n за месяц разбирает поток писем и обращений к базе знаний, суммарно подавая на вход модели 1 млн входных токенов и генерируя 200 тыс. выходных токенов. Если на этапе первичной классификации и простых ответов используется YandexGPT Lite в синхронном режиме, прямые затраты на генерацию составят:
(1 000 × 0,2 ₽) + (200 × 0,2 ₽) = 200 ₽ + 40 ₽ = 240 ₽ с НДС.
Если для сложных задач маршрутизации подключить YandexGPT Pro 5.1, тот же объем токенов обойдется в (1 000 × 0,8 ₽) + (200 × 0,8 ₽) = 960 ₽ с НДС. Обратите внимание: это стоимость исключительно генерации текста, без учета затрат на создание эмбеддингов, хранение базы, сервер n8n и работу разработчиков.
Условный расчет № 2 (распознавание звонков для агента контроля качества):
Предположим, сценарий n8n забирает из АТС 1 000 двухканальных аудиозаписей разговоров средней длительностью по 300 секунд (5 минут) каждая и отправляет их в Yandex SpeechKit. По официальному прайсу SpeechKit (проверено 3 ноября 2026 года, с НДС), стандартное асинхронное распознавание двухканального аудио стоит 0,1515 ₽ за 15 секунд (минимальная тарификация — 15 секунд, далее посекундно; число каналов округляется вверх до четного; для отложенного асинхронного режима действует ставка 0,0381 ₽ за 15 секунд, для синхронного/потокового одноканального — 0,1626 ₽ за 15 секунд с округлением фрагментов вверх до 15 секунд).
Считаем стоимость стандартной асинхронной расшифровки партии из 1 000 звонков:
1 000 файлов × (300 сек / 15 сек) × 0,1515 ₽ = 1 000 × 20 × 0,1515 ₽ = 3 030 ₽ с НДС.
К этой сумме затем добавится стоимость токенов LLM, которая будет анализировать полученные текстовые транскрибации.
3. Инфраструктура для локальных моделей (если облачные API не подходят)
Если компания решает развернуть LLM локально в связке с self-hosted n8n, потребуется сервер с достаточным объемом видеопамяти (VRAM).
Предварительно оценить минимальный объем памяти только под веса модели (например, при запуске через llama.cpp) можно по базовой формуле: число параметров × битность квантования / 8.
Условный расчет памяти: для модели на 8 млрд параметров в 4-битном квантовании сами веса займут 8 000 000 000 × 4 / 8 = 4 млрд байт (около 3,73 GiB). Однако в реальной эксплуатации поверх весов модели видеопамять расходуется на контекстное окно (KV-кеш, который растет при параллельных запросах от n8n), служебные буферы и накладные расходы, а для моделей архитектуры MoE (Mixture of Experts) в память приходится загружать все размещаемые веса, а не только активные параметры. Поэтому для серьезных моделей на 30–70 млрд параметров требуются ускорители с большим объемом VRAM — к примеру, по официальной спецификации NVIDIA (проверено 2 ноября 2026 года), видеокарта GeForce RTX 5090 оснащается 32 GB GDDR7, чего хватит далеко не для каждой тяжелой модели с длинным контекстом.
Если арендовать сервер с GPU у российских хостинг-провайдеров, порядок цифр можно оценить по публичным стартовым предложениям FirstVDS (проверено 2 ноября 2026 года; бесплатного тестового периода нет, минимальный срок оплаты — 1 сутки):
- аренда конфигурации с разделяемым vGPU L40S начинается от 299 ₽ в сутки (при неизменной посуточной ставке условный расчет на 30 суток составит 8 970 ₽);
- выделенный GPU Passthrough (в линейке представлены конфигурации с L4, RTX 4090, RTX 5090, L40S — стоимость и доступность конкретной карты различаются) начинается от 1 150 ₽ в сутки (условный расчет на 30 суток по нижней планке — 34 500 ₽). Конкретный объем выделенной видеопамяти, фиксированный месячный тариф и налоговые условия необходимо уточнять при заказе сервера.
4. Стоимость разработки и интеграции под ключ
Затраты на сборку самого сценария, настройку базы знаний, промпт-инжиниринг и тестирование зависят от числа интеграций. В качестве отдельного рыночного ориентира (проверено 2 ноября 2026 года): в публичном прайсе подрядчика Goose AI (gooseai.ru/ceny) внедрение готового агента из каталога со сценариями, интеграциями и тестированием оценивается в диапазоне 150 000 – 300 000 ₽ (это предложение конкретного участника рынка, а не среднерыночная статистика и не прайс нашей компании).
Для проектов индивидуальной разработки в «ЭйАй Бизнес» итоговая смета рассчитывается после предпроектного обследования процессов и фиксируется на странице /ceny.
| Составляющая проекта внедрения ИИ-агента | От чего зависит трудоемкость и стоимость |
|---|---|
| Проектирование архитектуры и аудит процессов | Число подразделений, наличие формализованных регламентов, требования 152-ФЗ и информационной безопасности. |
| Развертывание контура (n8n + БД + векторное хранилище) | Выбор между облаком и On-Premise, настройка отказоустойчивости, резервного копирования и мониторинга ошибок. |
| Подготовка корпоративной базы знаний (RAG) | Объем и качество исходных документов (PDF, таблицы, вики), необходимость очистки данных и настройки фильтров payload в Qdrant. |
| Разработка прикладных коннекторов (1С, ERP, CRM, MAX) | Наличие готового API у систем заказчика либо необходимость доработки HTTP-сервисов на стороне 1С. |
| Настройка промптов, защитных правил и тестирование | Количество инструментов агента, проверка на устойчивость к некорректным запросам и обучение сотрудников работе с веткой ручной проверки. |
Юридические ограничения: 152-ФЗ при работе с ИИ-агентами в России
Подключение языковых моделей к рабочим процессам в n8n почти всегда затрагивает персональные данные клиентов или сотрудников: ФИО, телефоны, адреса доставки, записи голоса, ИНН или историю заказов. Опираясь на официальный текст Федерального закона № 152-ФЗ «О персональных данных» (проверено 3 ноября 2026 года по публикациям на официальных ресурсах Минтруда России и Росгвардии), выделим пять критических правил, которые напрямую влияют на архитектуру сценария в n8n.
- Локализация баз данных при сборе (ч. 5 ст. 18 152-ФЗ в редакции 23-ФЗ от 28.02.2025). Закон запрещает при сборе персональных данных граждан РФ осуществлять запись, систематизацию, накопление, хранение, уточнение и извлечение таких данных с использованием баз данных, находящихся за пределами территории РФ (за исключением случаев, прямо предусмотренных законом). Нельзя руководствоваться устаревшими трактовками о том, что «достаточно просто сначала сохранить запись в российской БД, а затем бесконтрольно дублировать в зарубежные облака». Если ваш основной экземпляр n8n или подключенная к нему база памяти первично собирает анкеты клиентов на зарубежном сервере — это прямой риск нарушения.
- Трансграничная передача данных (ст. 12 152-ФЗ). Если сценарий n8n отправляет промпты с персональными данными на серверы иностранных LLM-провайдеров, это квалифицируется как трансграничная передача. Она требует подачи отдельного предварительного уведомления в уполномоченный орган о намерении осуществлять такую передачу (обычное уведомление об обработке персданных его не заменяет). При этом сам факт подачи уведомления автоматически не легализует любую передачу — регулятор вправе запретить или ограничить ее.
- Правовые основания, согласия и поручение обработки (ст. 6 и ст. 9 152-ФЗ). Закон допускает разные правовые основания обработки (не только согласие субъекта, но и, например, исполнение договора). Однако если согласие требуется, статья 9 предписывает оформлять его отдельно от иных информации и документов, которые подтверждает или подписывает человек. А если вы передаете данные через API стороннему облачному провайдеру или подрядчику, часть 3 статьи 6 требует наличия корректного поручения оператора на обработку персональных данных в договоре с провайдером.
- Иллюзия «быстрого обезличивания» в промпте (ст. 3 152-ФЗ). Разработчики часто ставят в n8n перед узлом нейросети скрипт, который заменяет фамилию клиента на маску
[КЛИЕНТ], полагая, что данные стали обезличенными. По статье 3 закона обезличивание — это действия, в результате которых становится невозможным без использования дополнительной информации определить принадлежность данных конкретному субъекту. Если вы удалили имя, но оставили в тексте обращения телефон, ИНН физлица, адрес или уникальный контекст ситуации, данные не считаются корректно обезличенными. - Ограничение чисто автоматизированных решений и меры защиты (ст. 16, 18.1, 19 152-ФЗ). Статья 16 ограничивает принятие на основании исключительно автоматизированной обработки решений, которые порождают юридические последствия в отношении человека или иным образом затрагивают его права и законные интересы (за исключением установленных законом случаев). Например, в HR-сценариях или скоринге нельзя поручать ИИ-агенту в n8n окончательный юридически значимый отказ человеку без участия сотрудника. Кроме того, даже установка полностью локальной LLM на собственном сервере сама по себе не означает соблюдения 152-ФЗ: статьи 18.1 и 19 требуют пакета внутренних организационных, правовых и технических мер защиты.
Рекомендация: перед переводом любого ИИ-агента в промышленную эксплуатацию обязательно проведите юридический аудит конкретного процесса, договоров с облачными провайдерами, перечня передаваемых полей и актуальной редакции законодательства.
Пошаговый чек-лист: как внедрить ИИ-агента в n8n и не потерять бюджет
Чтобы проект не застрял на стадии бесконечной отладки промптов, запускайте разработку по пяти последовательным шагам:
- Отделите жесткую логику от генеративной. Нарисуйте схему процесса. Проверку форматов, вычисление сумм, фильтрацию по статусам и маршрутизацию по известным полям вынесите в стандартные узлы n8n. Узлу
AI Agentоставьте только те шаги, где требуется понять смысл неструктурированного текста или выбрать инструмент из нескольких вариантов. - Проверьте готовые отраслевые сервисы. Если задача сводится к типовому вводу счетов в 1С или базовому анализу тендеров, сопоставьте стоимость кастомной разработки в n8n с покупкой готовой лицензии (например, 1С:РПД или специализированных отраслевых платформ).
- Изолируйте инструменты через дочерние сценарии и API с узкими правами. Не давайте агенту прямых учетных данных от продакшн-баз. Для работы с 1С опубликуйте ограниченные HTTP-сервисы под конкретные операции, а в векторной базе Qdrant настройте принудительную серверную фильтрацию
payloadпо правам доступа. - Заложите ветку проверки человеком (Human-in-the-loop) и логирование. Настройте сценарий так, чтобы ответы по нестандартным вопросам, черновики документов и финансовые операции сначала уходили сотруднику на подтверждение в корпоративный мессенджер или интерфейс CRM.
- Сведите юнит-экономику и требования 152-ФЗ на пилотном потоке. Замерьте реальный расход входных и выходных токенов на 100–200 реальных задачах, установите жесткие лимиты на глубину памяти диалога и согласуйте контур размещения (российские облачные API или собственный сервер) со службой безопасности и юристами.
Нужна помощь с внедрением?
Если вы планируете развернуть ИИ-агентов в контуре своей компании, связать n8n с 1С, CRM и внутренними базами знаний без нарушения требований безопасности, команда «ЭйАй Бизнес» поможет пройти этот путь от расчета экономики до запуска в эксплуатацию. Мы проектируем гибридные сценарии, где нейросети работают под контролем надежной инженерной логики.
Изучите подробнее наш подход и оставьте заявку на консультацию на странице услуги по автоматизации бизнеса.