
Тендерный отдел редко проигрывает из-за того, что не умеет пользоваться поиском на площадках. Чаще не хватает времени на рутину: специалист скачивает архив из десятка файлов, бегло читает стостраничное техническое задание, пропускает неочевидное требование к обеспечению или характеристике товара в приложении к проекту контракта — и компания либо подает невыгодную заявку, либо получает отклонение по формальному признаку.
Использование ИИ для тендеров меняет сам процесс первичного отбора и подготовки документов. Языковые модели и системы распознавания текста помогают за несколько минут сопоставить спецификацию заказчика со складской номенклатурой, найти нетипичные штрафы в проекте договора и собрать черновик заявки. При этом нейросеть не заменяет тендерного специалиста или юриста и не гарантирует победу в закупке: все требования и условия необходимо сверять с актуальной документацией конкретной процедуры. Если компании нужно связать анализ закупок с внутренним каталогом товаров, CRM и корпоративной базой знаний, мы проектируем такие решения в рамках внедрения ИИ-систем для бизнеса.
Какие задачи в закупках решает искусственный интеллект, а где нужен человек
Применение ИИ в закупках работает как фильтр и черновой аналитик. Алгоритмы хорошо справляются с извлечением фактов из неструктурированного текста, но не несут юридической или финансовой ответственности за поданную заявку. Чтобы автоматизация не привела к попаданию в реестр недобросовестных поставщиков или работе в убыток, важно разделить операции между программой и экспертом.
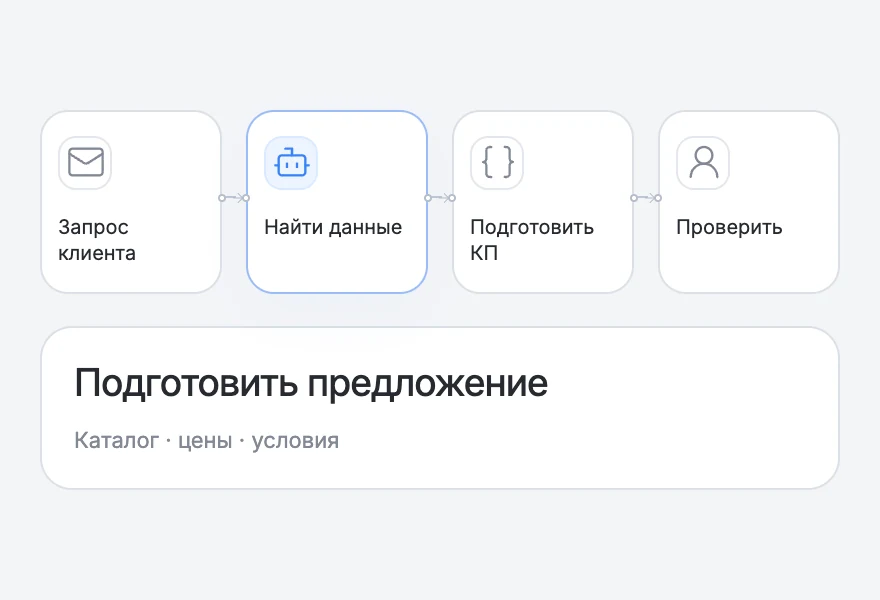
На практике автоматизацию делят на четыре этапа:
- Первичный отбор (скоринг) процедур. Стандартный поиск по ключевым словам или кодам ОКПД2 часто приносит лишние закупки, где нужный товар идет в одной связке со строительными работами или невыполнимыми лицензионными требованиями. Языковая модель читает предмет закупки и краткие условия, отсеивая заведомо неподходящие лоты до того, как специалист потратит время на выгрузку документации.
- Анализ технического задания и проекта контракта. Сотруднику не нужно вычитывать весь PDF-документ с нуля, чтобы понять базовые параметры сделки. ИИ извлекает из файлов ключевые условия в единую сводку: сроки поставки, место разгрузки, требования к гарантии, размер обеспечения заявки и исполнения контракта, порядок оплаты и нетипичные пени.
- Сопоставление номенклатуры (мэтчинг). Когда в техническом задании перечислены десятки позиций с диапазонами характеристик («не менее», «не более», эквиваленты), система с векторным поиском подбирает подходящие артикулы из прайс-листа поставщика и помечает позиции, по которым есть расхождения.
- Сборка черновика заявки и закрывающих документов. На основе проверенных данных система заполняет шаблоны таблиц с характеристиками товара, формирует черновики запросов на разъяснение документации, а после исполнения контракта — помогает быстро заносить первичные документы в учетную систему.
При этом финальная проверка всегда остается за человеком. Большие языковые модели (LLM) склонны к галлюцинациям: они могут неверно истолковать сложную формулировку с двойным отрицанием, пропустить сноску мелким шрифтом или перепутать редакции правил по 44-ФЗ и 223-ФЗ. Подписывать заявку электронной подписью без вычитки исходных разделов документации специалистом нельзя.
Готовый сервис или собственная система: два подхода к автоматизации
Выбор инструмента зависит от того, насколько стандартны ваши закупки и нужно ли связывать тендерный процесс с внутренними учетными системами компании. На российском рынке сложились два рабочих сценария: покупка подписки на готовый поисковый агрегатор со встроенным ИИ-модулем или сборка собственного пайплайна под внутренние регламенты.
| Критерий выбора | Готовый облачный сервис по закупкам | Собственная ИИ-система (кастомный пайплайн) |
|---|---|---|
| Сценарий использования | Быстрый поиск процедур и экспресс-оценка рисков в интерфейсе агрегатора | Глубокая сверка ТЗ с вашей базой товаров в 1С, автоматический расчет маржинальности и заполнение форм |
| Затраты на старте | Годовая стоимость лицензии по тарифу вендора | Оплата проектирования, настройки интеграций, инфраструктуры и токенов |
| Связь с внутренним учетом | Ограничена возможностями штатного интерфейса или отдельного API (условия уточняются у поставщика) | Прямой обмен данными с ERP, 1С, CRM и внутренним хранилищем документов |
| Контроль над данными | Обработка проходит в облаке поставщика сервиса | Возможность выбора облачного API с отключенным логированием или размещение на собственных серверах |
1. Встроенные ИИ-инструменты в тендерных агрегаторах
Если главная задача — ускорить чтение извещений и первичный разбор документов прямо в окне поиска, разумно начать с готовых отраслевых продуктов.
Например, в сервисе Контур.Закупки (по данным официального прайс-листа zakupki.kontur.ru/price, проверено 3 ноября 2026 года) предусмотрен тариф «Эксперт + ИИ» стоимостью 57 800 рублей в год. В него входят возможности базового тарифа «Эксперт» (который без ИИ-пакета стоит 46 400 рублей в год), а также ИИ-ассистент по условиям и рискам тендера и ИИ-отчеты с анализом и рекомендациями.
При планировании бюджета важно учитывать, что 57 800 рублей в год — это стоимость лицензии конкретного вендора, а не разработка собственного агента и не плата за каждую отдельную закупку. Налоговый состав этой цены на странице прайса отдельно не подтвержден, а лимиты использования, точный состав лицензии, стоимость дополнительных рабочих мест и условия доступа к API необходимо уточнять у поставщика перед покупкой.
2. Автоматизация первичных документов на базе 1С
Отдельная задача в закупочном цикле — обработка входящих счетов от субподрядчиков и закрывающих документов по контрактам. Для этого не обязательно разрабатывать собственную нейросеть с нуля: в официальный каталог цифровых решений 1С (solutions.1c.ru, проверено 3 ноября 2026 года) входит специализированный сервис «1С:Распознавание первичных документов» (1С:РПД), который относится к инструментам ИИ в бухгалтерии.
По данным официального описания (v8.1c.ru, проверено 3 ноября 2026 года), сервис распознает счета, накладные ТОРГ-12, акты, счета-фактуры, УПД, УКД и кассовые чеки по сканам и фотографиям. Процесс устроен последовательно: пользователь загружает файлы, система распознает реквизиты и табличные части, человек проверяет результат и создает документы в учетной базе. Автоматическое проведение без проверки сотрудником здесь не предусмотрено, что защищает базу от ошибок распознавания.
Стоимость 1С:РПД зависит от годового пакета страниц (официальный прайс 1С:РПД, проверено 3 ноября 2026 года):
- 100 страниц — 600 ₽/год;
- 500 страниц — 2 500 ₽/год;
- 1 000 страниц — 4 500 ₽/год;
- 5 000 страниц — 21 000 ₽/год;
- 10 000 страниц — 40 000 ₽/год.
Также предусмотрен бесплатный тестовый пакет на 250 страниц (условия его подключения уточняются при заказе). Указанный объем — это лимит выбранного пакета на год, а не ежемесячное количество. При полном расходовании пакета на 10 000 страниц расчетная стоимость одной страницы составит 4 рубля, однако этот показатель нельзя переносить на стоимость индивидуальной доработки или нетиповой интеграции с вашей конфигурацией 1С. Налоговый состав цен на странице прайса отдельно не указан.
Как устроена кастомная ИИ-система для анализа закупок и подготовки заявок
Готового облачного агрегатора недостаточно, когда компании нужно автоматически сопоставлять сотни позиций из сложного ТЗ со своим номенклатурным справочником, проверять актуальные складские остатки и собирать заявку по внутренним корпоративным стандартам. В таких случаях выстраивают собственный программный конвейер (пайплайн).
Оркестрация процессов и инструменты агента
Для связки почты, тендерных выгрузок, парсеров документов и языковых моделей часто используют платформы процессной автоматизации, например n8n. Согласно официальной документации (docs.n8n.io, проверено 2 ноября 2026 года), n8n совмещает автоматизацию рабочих процессов и функции ИИ, выпускается под fair-code лицензией (поэтому продукт нельзя безоговорочно называть свободным ПО) и поддерживает как облачное использование, так и размещение на собственных серверах (self-hosted).
Внутри сценария за логику отвечает узел AI Agent. Как указано в документации репозитория (github.com/n8n-io/n8n-docs, проверено 3 ноября 2026 года), начиная с версии 1.82.0 выбор старых типов агентов устарел — современные узлы работают как Tools Agent. Узел соединяется с языковой моделью (chat model) и прикладными инструментами, самостоятельно выбирая вызовы под задачу, при этом подключение хотя бы одного дочернего инструмента (tool sub-node) обязательно.
Важно учитывать два технических ограничения:
- Для обращения к базам данных (например, чтобы проверить цены или историю прошлых контрактов) не используется устаревшая форма SQL Agent — вместо этого подключаются отдельные инструменты с узко настроенными правами доступа.
- Сама по себе связка языковой модели с узлом агента не создает готовых бизнес-интеграций и не гарантирует правильный порядок действий без жестко заданной логики сценария.
Если требуется связать ИИ-агента с внутренними сервисами по единому стандарту, используют Model Context Protocol (MCP). Согласно архитектурной документации (modelcontextprotocol.io, проверено 2 ноября 2026 года), протокол связывает приложение-хост (host), клиент (client) и сервер (server), который предоставляет инструменты (tools), ресурсы (resources) и шаблоны промптов (prompts) через транспорт stdio или Streamable HTTP. При этом сам протокол MCP не дает готовой интеграции с учетной системой: для связи с 1С потребуется разработка MCP-сервера, настройка прав доступа и реализация прикладных методов. Со стороны 1С для такого обмена можно задействовать штатные HTTP-сервисы (v8.1c.ru/platforma/http-servisy/, проверено 3 ноября 2026 года), где разработчик задает шаблоны URL и обработчики методов, управляя телом и кодом ответа.
Подбор номенклатуры через RAG и векторный поиск
Если просто загрузить в языковую модель длинный прайс-лист и попросить подобрать аналоги под ТЗ заказчика, модель быстро превысит лимит контекста или начнет выдумывать несуществующие характеристики. Чтобы этого избежать, применяют архитектуру RAG (Retrieval-Augmented Generation — генерация, дополненная поиском).
Техническое задание разбивается на отдельные товарные позиции, после чего система ищет подходящие карточки товаров в векторной базе данных, например Qdrant. Согласно официальной документации (qdrant.tech/documentation/ и разделу Filtering, проверено 3 ноября 2026 года), Qdrant позволяет сочетать векторный поиск со строгими фильтрами по метаданным (payload) и идентификаторам точек, а для ускорения фильтрации документация рекомендует создавать payload-индексы.
В тендерных задачах это критически важно по двум причинам:
- Точные параметры нельзя заменять смысловой близостью. Векторное сходство покажет, что «кабель силовой» близок к запросу заказчика, но только жесткий фильтр по метаданным гарантирует, что в подборку попадет товар в наличии, из нужного ценового диапазона и с точным сечением жилы. Само по себе наличие похожего вектора не доказывает правильность ответа, а технология RAG снижает риск выдумок модели, но не гарантирует стопроцентной точности без проверки человеком.
- Безопасность коммерческих данных. Если в одной базе хранятся прайс-листы с разной дилерской скидкой или закрытые паспорта изделий, права пользователя должна применять серверная логика и фильтр доступа на уровне БД. Полагаться на текстовую инструкцию в промпте вроде «не показывай менеджеру себестоимость» нельзя — добавление векторной базы автоматически не решает задачу разграничения прав.
Как это работает на близких задачах: реальные ориентиры рынка
В открытых источниках пока немного детально верифицированных отчетов именно о закрытых тендерных пайплайнах, но архитектура классификации документов и поиска по корпоративным базам знаний хорошо изучена на смежных задачах обработки сложных текстовых запросов.
Показателен кейс компании «Инфосистемы Джет» на базе технологий Yandex Cloud (yandex.cloud/ru/cases/jet, опубликован 13 февраля 2025 года, проверено 3 ноября 2026 года). Команда за полтора месяца провела пилот системы, которая классифицирует входящие обращения, ищет информацию по корпоративной базе знаний (с использованием Object Storage и OpenSearch) и формирует ответы, передавая часть из них сотруднику на проверку. По опубликованным результатам пилота со стороны заказчика и поставщика:
- до 30% обращений обрабатываются полностью автоматически;
- точность классификации около ста типов запросов составила 75%;
- корректность ответов языковой модели достигла до 80%.
Эти три разные метрики наглядно показывают, почему в серьезных бизнес-процессах (включая закупки) нельзя обещать «стопроцентную автоматизацию без участия человека»: даже при 80%-й корректности генерации ответов система берет на себя подготовку информации, а финальное решение по сложным случаям остается за специалистом.
Другой пример зрелого подхода к архитектуре — опыт Сбера по внедрению мультиагентной обработки обращений на базе Platform V Flow и GigaChat (сообщение поставщика решения СберТех на sbertech.ru от 23 сентября 2026 года, проверено 3 ноября 2026 года). Важна сама последовательность внедрения: сначала компания заменила CRM и автоматизировала процессы с жесткой детерминированной логикой, и только с 2025 года подключила большие языковые модели для работы со свободным текстом. В тендерном отделе действует тот же принцип: сначала настраиваются строгие правила маршрутизации заявок и контроля сроков, а затем к ним подключается LLM для чтения неструктурированных технических заданий.
Сколько стоит работа ИИ в закупках: модели, инфраструктура и интеграция
При расчете бюджета на собственное решение для анализа тендеров расходы складываются из трех частей: оплата обращений к языковым моделям (или аренда серверов с GPU), лицензии на инструменты оркестрации и стоимость работы интегратора. Ниже приведены проверенные публичные тарифы конкретных поставщиков (это рыночные ориентиры, а не прайс-лист нашей компании или среднерыночная статистика).
1. Облачные языковые модели по API
Для разбора текстовых документов в России чаще всего используют API отечественных провайдеров:
-
Yandex AI Studio. Платформа предоставляет генеративные модели, эмбеддинги, инструменты поиска по собственным данным и управление доступом (aistudio.yandex.ru/ru/docs/, проверено 2 ноября 2026 года). Согласно официальному прайс-листу для синхронного режима (aistudio.yandex.ru/ru/docs/ai-studio/pricing, проверено 3 ноября 2026 года, цены указаны в рублях с НДС за 1 000 токенов):
- Alice AI LLM Flash: вход — 0,1 ₽, выход — 0,2 ₽;
- YandexGPT Lite: вход — 0,2 ₽, выход — 0,2 ₽;
- YandexGPT Pro 5.1: вход — 0,8 ₽, выход — 0,8 ₽.
Цены входных и выходных токенов считаются раздельно (использование кеша и встроенных инструментов тарифицируется по отдельным правилам).
Условный учебный расчет: допустим, за месяц ваш тендерный отдел пропускает через модель YandexGPT Lite объем документации на 1 млн входных токенов и получает краткие сводки на 200 тыс. выходных токенов. Расход непосредственно на генерацию составит:
(1 000 × 0,2 ₽) + (200 × 0,2 ₽) = 200 + 40 = 240 рублейс НДС. Для более сложной модели YandexGPT Pro 5.1 тот же объем обойдется в800 + 160 = 960 рублейс НДС. Это затраты только на обращение к модели, без учета стоимости парсинга таблиц, хранения векторов и разработки. -
GigaChat API. Сервис поддерживает работу с текстами, файлами, изображениями, вызовами функций, эмбеддингами и структурированными данными (developers.sber.ru, проверено 2 ноября 2026 года). При расчете стоимости важно учитывать категорию клиента (официальные тарифы для юрлиц, страница обновлена 7 октября, проверено 2 ноября 2026 года):
- Для новых клиентов с 1 сентября 2026 года подключение и оплата проходят через платформу cloud.ru — актуальные тарифы для нового подключения необходимо запрашивать непосредственно у cloud.ru, автоматически переносить на них старые расценки нельзя.
- Для действующих клиентов «СалютДевайсы» / «Салют для Бизнеса» в синхронном режиме pay-as-you-go действуют тарифы за 1 000 токенов с НДС: GigaChat Lite — 0,065 ₽, GigaChat Pro — 0,5 ₽, GigaChat Max — 0,65 ₽ (минимальная сумма при фактическом использовании — 600 ₽/месяц; если обращений не было, плата не списывается).
2. Локальный запуск моделей и аренда GPU
Если служба безопасности требует обрабатывать документацию на выделенном контуре без передачи текстов во внешние облачные API, открытые языковые модели запускают с помощью инструментария вроде открытого проекта llama.cpp (github.com/ggml-org/llama.cpp, проверено 3 ноября 2026 года).
Для предварительной математической оценки того, сколько видеопамяти займут только сами веса модели, используют формулу: число параметров × число бит квантования / 8.
Условный пример: модель на 8 млрд параметров в 4-битном квантовании потребует под веса 8 000 000 000 × 4 / 8 = 4 млрд байт (около 3,73 GiB). Однако реальная потребность в видеопамяти при разборе длинных тендерных ТЗ будет существенно выше за счет KV-кеша (контекста), служебных буферов и накладных расходов, а для архитектур класса MoE (Mixture of Experts) память требуется под все размещаемые веса, а не только под активные параметры. Даже флагманская потребительская видеокарта уровня NVIDIA GeForce RTX 5090 с официальным объемом памяти 32 GB GDDR7 (nvidia.com, проверено 3 ноября 2026 года) сама по себе не гарантирует запуск любой крупной LLM с большим окном контекста.
Если не покупать собственное серверное оборудование, инфраструктуру с видеокартами арендуют. Например, у российского хостинг-провайдера FirstVDS (firstvds.ru/products/vps-vds-gpu, проверено 2 ноября 2026 года) публичные стартовые предложения начинаются:
- от 299 ₽/сутки за конфигурацию с vGPU L40S;
- от 1 150 ₽/сутки за выделенный GPU Passthrough (в линейке представлены карты L4, RTX 4090, RTX 5090, L40S — при этом разные модели карт стоят по-разному, это лишь нижняя граница класса услуг).
Минимальный оплачиваемый срок составляет 1 сутки, бесплатного тестового периода нет. Если условно пересчитать нижние границы на 30 суток при неизменной посуточной ставке, получится 8 970 ₽ и 34 500 ₽ соответственно (это расчетная величина, а не специальный месячный тариф; наличие нужной карты, объем выделенной видеопамяти и налоговые условия необходимо проверять при заказе).
3. Платформы оркестрации и услуги по разработке
Для связки компонентов в единый процесс также закладывают бюджет на ПО и интеграцию:
- Оркестраторы. В облачной версии n8n (n8n.io/pricing/, проверено 3 ноября 2026 года) тариф Starter при годовой оплате составляет эквивалент 20 евро в месяц за 2 500 исполнений сценариев (workflow executions), а тариф Pro — 50 евро в месяц за 10 000 исполнений. Для сравнения: в платформе Make (make.com/pricing, проверено 3 ноября 2026 года) тарификация идет не по запускам сценария целиком, а в кредитах за отдельные действия модулей (есть бесплатный план на 1 000 кредитов в месяц, но один сложный сценарий анализа закупки может расходовать десятки кредитов за один проход). Для российских компаний возможность оплаты зарубежных облачных подписок требует отдельной проверки, поэтому на практике часто выбирают self-hosted установку на российском сервере.
- Разработка и внедрение. Стоимость создания кастомного решения на рынке зависит от глубины интеграции с 1С и CRM. Для ориентира по сегменту готовых сценариев: у подрядчика Goose AI (gooseai.ru/ceny/, проверено 3 ноября 2026 года) развертывание готового агента из каталога со сценариями, интеграциями и тестированием оценивается в диапазоне 150 000–300 000 рублей (это публичное предложение конкретного разработчика, а не среднерыночный показатель).
Когда система проектируется под индивидуальный закупочный процесс компании, итоговая смета формируется из следующих этапов (ознакомиться с подходом нашей команды и запросить расчет можно на странице услуг и стоимости):
| Составляющая проекта | Что входит в работы | От чего зависит стоимость |
|---|---|---|
| Проектирование и аудит документации | Разбор типовых ТЗ, проектов контрактов и форм заявок компании, составление схемы данных | Количество площадок, разнообразие форматов (сканы, таблицы, чертежи) |
| Настройка парсинга и базы знаний (RAG) | Извлечение текста из архивов, развертывание векторной БД (например, Qdrant), индексация прайс-листов | Объем номенклатурного справочника и частота обновления цен |
| Интеграция с учетными системами | Настройка обмена с 1С (через HTTP-сервисы), CRM и корпоративным порталом или мессенджером | Сложность текущей конфигурации 1С и требования к правам доступа |
| Тестирование и контроль качества | Проверка точности извлечения параметров на исторических закупках, настройка защитных фильтров | Количество проверяемых критериев риска и ролей пользователей |
Дополнительные инструменты: голосовые коммуникации и чат-боты
В коммерческих закупках и при согласовании спецификаций с поставщиками много деталей обсуждается голосом. Если компании нужно фиксировать договоренности тендерных специалистов по телефону, в пайплайн добавляют сервисы распознавания речи. Например, в Yandex SpeechKit (aistudio.yandex.ru/ru/docs/speechkit/stt/ и прайс-лист, проверено 3 ноября 2026 года) стандартное асинхронное распознавание двухканальных записей (до 4 часов) стоит 0,1515 ₽ с НДС за 15 секунд (минимум 15 секунд, далее посекундно; отложенное асинхронное — 0,0381 ₽ за 15 секунд).
Условный расчет: расшифровка 1 000 двухканальных звонков поставщикам длительностью по 300 секунд (5 минут) в стандартном асинхронном режиме обойдется в 1 000 × (300 / 15) × 0,1515 = 3 030 рублей с НДС (только за перевод речи в текст, без последующего анализа через LLM). Для крупных контакт-центров существует отдельный аналитический продукт SpeechSense (aistudio.yandex.ru/ru/docs/speechsense/pricing, проверено 3 ноября 2026 года) с пакетными тарифами от 45 000 ₽ в месяц с НДС за 10 000 минут, но для точечных задач отдела закупок обычно достаточно базовой расшифровки через SpeechKit.
Если уведомления о новых тендерах и краткие сводки по рискам нужно отправлять руководителю в российский корпоративный мессенджер, можно настроить чат-бота на платформе MAX. По официальной инструкции (dev.max.ru/docs/chatbots/bots-create/create, проверено 3 ноября 2026 года), для создания бота требуется подключение к платформе партнеров и верификация профиля организации, ИП или самозанятого — резидента РФ (юрлица и ИП могут создать до 5 ботов, самозанятые — до 2, а токен выпускается через веб-платформу или мини-приложение «MAX для бизнеса»).
Юридические ограничения и защита данных по 152-ФЗ при работе с тендерами
В составе тендерной заявки и конкурсной документации регулярно встречаются персональные данные: паспорта и дипломы ключевых специалистов (для подтверждения квалификации на конкурсах), доверенности, телефоны, адреса электронной почты и ИНН физических лиц. Передача таких документов во внешние ИИ-сервисы без соблюдения Федерального закона № 152-ФЗ «О персональных данных» создает прямые правовые риски для компании.
Опираясь на опубликованный текст 152-ФЗ (mintrud.gov.ru/docs/laws/130 и rosguard.gov.ru, проверено 3 ноября 2026 года), при проектировании ИИ-системы для закупок необходимо учитывать пять правил:
- Запрет на использование зарубежных баз при сборе данных. Часть 5 статьи 18 152-ФЗ (в редакции Федерального закона № 23-ФЗ от 28.02.2025) запрещает при сборе персональных данных граждан РФ выполнять перечисленные в законе операции с использованием баз данных, находящихся за пределами территории РФ (за исключением случаев, прямо предусмотренных законом). Нельзя опираться на устаревшее представление о том, что данные достаточно «сначала сохранить в России», и отправлять сканы анкет сотрудников в зарубежные облачные нейросети.
- Правила трансграничной передачи. Статья 12 закона требует подачи отдельного предварительного уведомления регулятора о намерении осуществлять трансграничную передачу персональных данных (обычное уведомление об обработке ПДн его не заменяет, и сам факт подачи уведомления автоматически не легализует любую передачу в любой зарубежный ИИ-сервис).
- Правовые основания и договоры с подрядчиками. Статья 6 допускает разные правовые основания обработки данных, но если вы передаете обработку внешнему облачному провайдеру или интегратору, требуется корректно оформленное поручение оператора с соблюдением установленных законом требований. Если используется согласие субъекта, статья 9 требует оформлять его отдельно от иных подтверждаемых или подписываемых документов. При этом наличие согласия не отменяет требований по локализации и информационной безопасности.
- Требования к обезличиванию. Часто компании пытаются удалить из проекта договора фамилию подписанта перед отправкой в LLM, считая документ обезличенным. Однако по статье 3 152-ФЗ обезличивание означает невозможность без использования дополнительной информации определить принадлежность данных конкретному субъекту. Оставленный в тексте ИНН физлица, прямой телефон, редкая должность или узнаваемый контекст портфолио сохраняют связь с человеком.
- Ограничение чисто автоматических решений и меры защиты. Статья 16 ограничивает принятие решений, порождающих юридические последствия для человека или затрагивающих его права, исключительно на основании автоматизированной обработки (с предусмотренными законом исключениями). А статьи 18.1 и 19 обязывают оператора принимать организационные и технические меры защиты. Поэтому развертывание локальной LLM на собственном сервере само по себе не означает автоматического соблюдения 152-ФЗ — перед запуском процесса необходимо проверить договоры с поставщиками API (включая настройки запрета на логирование данных в том же Yandex AI Studio), перечень получателей и актуальную редакцию закона вместе с профильным юристом.
С чего начать внедрение ИИ в тендерный отдел: пошаговый план
Чтобы автоматизация закупок не превратилась в бесконечный ИТ-проект, внедрение стоит разбить на короткие этапы с измеримым результатом:
- Зафиксируйте узкое место на реальных документах. Соберите 20–30 архивов прошлых закупок, в которых участвовала компания (включая те, где заявку отклонили или где менеджеры потратили больше всего времени на расчет). Определите, на каком шаге теряется время: первичный отсев извещений, вычитка длинных проектов контрактов или подбор товарных позиций под ТЗ.
- Разделите задачи между готовым ПО и кастомной разработкой. Если проблема только в поиске по площадкам и базовой сводке рисков, протестируйте готовые модули тендерных агрегаторов. Если требуется сверять спецификации на десятки позиций с вашей базой в 1С и считать маржинальность с учетом закупочных цен — переходите к проектированию собственного конвейера с RAG.
- Очистите и структурируйте внутренний справочник номенклатуры. Никакая языковая модель не сопоставит техническое задание заказчика с вашей базой в 1С, если карточки товаров внутри компании заполнены хаотично, без единых единиц измерения и технических характеристик.
- Настройте контур безопасности и фильтрацию данных. Определите, какие документы содержат персональные данные и коммерческую тайну. Выберите архитектуру (российский облачный провайдер с корпоративным договором и отключенным сохранением логов либо выделенный сервер с GPU) и закрепите правило обязательной финальной верификации заявки тендерным специалистом.
Нужна помощь с внедрением?
Если ваш тендерный отдел тратит слишком много времени на ручную вычитку технических заданий и сверку длинных спецификаций с учетной системой, мы поможем спроектировать и внедрить надежную архитектуру под ваши регламенты. Команда ЭйАй Бизнес настраивает кастомные пайплайны анализа закупочной документации, связывает векторный поиск с 1С и CRM и обучает сотрудников безопасной работе с ИИ-инструментами. Перейдите на главную страницу услуги, чтобы обсудить задачу и подобрать решение под ваш объем торгов.