
Передавать персональные данные нейросети закон не запрещает сам по себе, но любая отправка клиентской анкеты, записи звонка или резюме во внешний сервис с юридической точки зрения остается обработкой персональных данных. Ошибка многих компаний в том, что они воспринимают промпт как черновик или устный разговор, тогда как для регулятора запрос к внешнему API — это передача сведений третьему лицу, нередко за пределы России. Чтобы соблюдать требования по связке ИИ и 152-ФЗ, бизнесу нужно до запуска проверить четыре вещи: где физически находятся базы данных, на каком правовом основании обрабатываются сведения, как оформлен договор с поставщиком модели и не принимает ли алгоритм юридически значимых решений без участия человека. Если данные нельзя выводить за пределы компании даже в российское облако, задачу решают через развертывание локальных LLM в собственном контуре.
Что происходит с точки зрения закона, когда сотрудник отправляет промпт
Когда менеджер копирует переписку с клиентом в окно чат-бота или корпоративная система отправляет карточку заказа по API в языковую модель, происходит сбор, запись, систематизация, накопление, хранение, извлечение, использование или передача информации. Если в этом тексте есть фамилия, телефон, адрес доставки, электронная почта или сочетание деталей, по которым можно определить конкретного человека, вступают в силу правила Федерального закона № 152-ФЗ «О персональных данных» (здесь и далее правовые нормы приведены по опубликованному Минтрудом тексту 152-ФЗ, проверено 3 ноября 2026 года).
На практике компании сталкиваются с тремя типичными сценариями:
- Стихийное использование публичных зарубежных сервисов. Сотрудники без ведома ИБ-отдела загружают договоры, таблицы с контактами или резюме кандидатов в браузерные версии иностранных нейросетей. Здесь нужно проверить несколько условий: правовое основание передачи, оформление отношений с получателем, соблюдение требований локализации и порядка трансграничной передачи. Самостоятельное действие сотрудника не подтверждает, что компания выполнила эти требования.
- Подключение российского облачного API. Компания интегрирует отечественную модель в CRM или хелпдеск. С локализацией серверов вопрос решается проще, но остаются требования к договору поручения, основаниям обработки, целям и срокам хранения логов на стороне провайдера и защите канала связи.
- Размещение открытой модели на собственных серверах (on-premise). Данные не покидают инфраструктуру заказчика, сторонний провайдер ИИ к ним доступа не получает. Однако сама по себе локальная установка не освобождает компанию от обязанностей оператора персональных данных.
Чтобы выбрать подходящую архитектуру и не блокировать автоматизацию из-за опасений юристов, нужно разобрать каждую ключевую норму 152-ФЗ применительно к работе с языковыми и речевыми моделями.
Локализация и трансграничная передача: почему зарубежные API создают главный риск
Главная преграда для легального использования иностранных облачных LLM при работе с данными россиян — требования к месту обработки и правила пересечения границы.
Запрет на использование зарубежных баз при сборе (ч. 5 ст. 18 152-ФЗ)
Часть 5 статьи 18 152-ФЗ (в редакции Федерального закона № 23-ФЗ от 28.02.2025) прямо запрещает при сборе персональных данных граждан РФ осуществлять запись, систематизацию, накопление, хранение, уточнение (обновление, изменение) и извлечение персональных данных с использованием баз данных, находящихся за пределами территории Российской Федерации, за исключением случаев, прямо предусмотренных законом (текст 152-ФЗ на сайте Минтруда, проверено 03.11.2026).
В деловой среде до сих пор встречается устаревшее убеждение: якобы достаточно сначала записать данные клиента в российскую CRM («первичная база в РФ»), а затем можно свободно отправлять их в любую зарубежную систему. Опираться на такую упрощенную формулу рискованно. Если внешний ИИ-сервис при сборе данных или интеграции с вашими формами записывает и накапливает запросы на зарубежных серверах, это прямо противоречит ч. 5 ст. 18.
В то же время закон не объявляет безусловно запрещенной вообще любую последующую трансграничную передачу при наличии законных оснований и соблюдении процедуры. Но для работы с массовыми клиентскими запросами через зарубежный API выполнить эти условия крайне сложно.
Уведомление о трансграничной передаче (ст. 12 152-ФЗ)
Отправка промпта с персональными данными на сервер иностранного провайдера (в США, ЕС или любую другую страну) является трансграничной передачей. Статья 12 152-ФЗ требует от оператора подать в уполномоченный орган (Роскомнадзор) отдельное предварительное уведомление о намерении осуществлять трансграничную передачу персональных данных (источник, проверено 03.11.2026).
Здесь важно учитывать два практических ограничения:
- Обычное уведомление об обработке ПДн его не заменяет. Даже если ваша компания давно состоит в реестре операторов Роскомнадзора, для передачи данных за рубеж требуется отдельная процедура.
- Подача уведомления не легализует любую передачу автоматически. Оператор обязан до подачи уведомления запросить у иностранного контрагента сведения о мерах по защите передаваемых данных и условиях прекращения их обработки. Попытка запросить такие индивидуальные гарантии и подписать соглашение по российскому праву у глобального зарубежного ИИ-сервиса при стандартной подписке с корпоративной карты практически нереализуема. Кроме того, регулятор вправе запретить или ограничить передачу по результатам рассмотрения уведомления.
Правовые основания, согласие и поручение на обработку
Даже когда нейросеть персональные данные по 152-ФЗ обрабатывает строго внутри России, оператор обязан соблюдать правила статей 6 и 9 закона.
На каком основании данные попадают в модель (ст. 6 и ст. 9 152-ФЗ)
Статья 6 152-ФЗ допускает несколько правовых оснований для обработки персональных данных — это не только согласие субъекта, но и, например, исполнение договора, стороной или выгодоприобретателем по которому является человек, либо выполнение возложенных законом обязанностей (источник, проверено 03.11.2026).
Однако если вы привлекаете внешний облачный сервис ИИ (пусть даже российский), вы передаете данные третьему лицу. Для этого необходимы два условия:
- Законное основание для передачи. Для обработки по поручению действует часть 3 статьи 6: по общему правилу нужно согласие субъекта, если иное не предусмотрено федеральным законом. Условия конкретной передачи и роль провайдера необходимо проверить отдельно. По статье 9 152-ФЗ согласие на обработку персональных данных должно быть конкретным, предметным, информированным, сознательным и однозначным, а главное — оформляться отдельно от иных информации и (или) документов, которые подтверждает и (или) подписывает субъект персональных данных (источник, проверено 03.11.2026). Спрятать строчку о передаче данных внешним ИИ-провайдерам внутри многостраничной публичной оферты недостаточно. Кроме того, наличие согласия человека не отменяет требований закона к локализации баз и технической безопасности.
- Поручение оператора (ч. 3 ст. 6 152-ФЗ). Когда внешний облачный провайдер предоставляет вам API языковой или речевой модели, он выступает лицом, обрабатывающим персональные данные по поручению оператора. В договоре с ним (или в специальном приложении об обработке ПДн) должны быть четко определены перечень персональных данных, перечень действий с ними, цели обработки, обязанность соблюдать конфиденциальность и требования к защите в соответствии со статьей 19 закона.
Крупные российские облачные платформы предусматривают механизмы для корпоративных заказчиков. Например, документация Yandex AI Studio (проверено 02.11.2026) описывает не только генеративные модели, эмбеддинги и управление доступом, но и отдельные правила хранения данных и возможность отключения логирования запросов. Это критично: если провайдер не сохраняет ваши промпты и ответы для дообучения своих моделей, юридические и коммерческие риски снижаются, хотя необходимость корректного договора это не отменяет.
Спасает ли маскирование и обезличивание текста перед отправкой в API
Популярное техническое предложение от разработчиков звучит так: «Давайте перед отправкой текста в зарубежную или облачную LLM вырезать регулярными выражениями ФИО и номера паспортов, заменяя их на токен [КЛИЕНТ_1]». С точки зрения информационной безопасности это полезная мера (data masking), но с юридической точки зрения она далеко не всегда превращает текст в неперсональные данные.
Согласно статье 3 152-ФЗ, обезличивание персональных данных — это действия, в результате которых становится невозможным без использования дополнительной информации определить принадлежность персональных данных конкретному субъекту (источник, проверено 03.11.2026).
Почему простого удаления имени недостаточно:
- Остаются косвенные и прямые идентификаторы. Если фильтр заменил «Иванов Иван Иванович» на
[ФИО], но в тексте обращения или счета остались ИНН физического лица, номер телефона, адрес электронной почты, номер договора, адрес квартиры или ссылка на профиль в соцсети, связь с конкретным человеком сохраняется. - Узнаваемый контекст в неструктурированном тексте. В медицинских выписках, подробных резюме кандидатов, жалобах клиентов или расшифровках звонков комбинация должности, названия города, даты события и специфических деталей ситуации часто позволяет однозначно вычислить человека без имени.
- Псевдонимизация обратима. Если ваша система хранит таблицу соответствия
[КЛИЕНТ_1] = Иванов И. И., для вас как оператора эти данные остаются персональными, а при ошибке парсера (например, клиент написал фамилию с опечаткой или в нестандартном падеже) реальные данные уйдут во внешний API в открытом виде.
Поэтому маскирование данных перед отправкой в облако стоит использовать как дополнительный рубеж защиты, но строить на нем единственное юридическое обоснование для работы с зарубежным ИИ рискованно.
Автоматизированные решения без участия человека: ограничения статьи 16
Еще один важный аспект — как именно бизнес использует ответ нейросети. Компании стремятся автоматизировать скоринг заемщиков, первичный отсев кандидатов в HR, рассмотрение претензий или расчет индивидуальных условий.
Статья 16 152-ФЗ запрещает принятие на основании исключительно автоматизированной обработки персональных данных решений, которые порождают юридические последствия в отношении субъекта персональных данных или иным образом затрагивают его права и законные интересы, за исключением случаев, предусмотренных законом (например, при наличии письменного согласия субъекта или в случаях, установленных федеральными законами) (текст закона на сайте Минтруда, проверено 03.11.2026; публикация на сайте Росгвардии, проверено 03.11.2026).
Что это значит на практике:
- Это не полный запрет на ИИ в HR или клиентском сервисе. Нейросеть может ранжировать отклики, составлять краткую сводку по резюме, классифицировать обращения в поддержку или готовить проект ответа. Правовую допустимость конкретного HR-процесса или клиентского конвейера всегда должен проверять профильный юрист.
- Принцип Human-in-the-Loop (человек в контуре) защищает и от правовых, и от бизнес-ошибок. Если решение об отказе в приеме на работу, блокировке счета или отклонении официальной претензии принимает штатный специалист после проверки черновика, подготовленного ИИ, обработка перестает быть «исключительно автоматизированной». Кроме того, оператор обязан разъяснить человеку порядок принятия решения и дать возможность заявить возражение.
Где в реальных бизнес-процессах возникают персональные данные
Чтобы оценить применимость облачных и локальных решений, посмотрим на четыре частых сценария, в которых российские компании внедряют ИИ.
1. Обработка клиентских обращений и базы знаний (RAG)
В службах поддержки и сервисных подразделениях обращения клиентов почти всегда содержат ФИО, контакты и детали договоров.
Показателен публичный кейс компании «Инфосистемы Джет» на платформе Yandex Cloud (опубликован 13 февраля 2025, проверен 3 ноября 2026). За полтора месяца пилота команда внедрила систему, которая классифицирует запросы, ищет информацию по базе знаний (на базе Object Storage и OpenSearch) и формирует ответы. Результаты именно пилотного проекта поставщик и заказчик разделяют на три разные метрики: до 30% обращений обрабатываются автоматически, точность классификации около ста типов обращений составила 75%, а корректность ответов LLM — до 80%. При этом часть ответов система передает сотруднику для проверки перед отправкой.
Другой крупный пример — сообщение компании СберТех от 23 сентября 2026 года (источник) о внедрении в Сбере мультиагентной обработки клиентских обращений на базе Platform V Flow и GigaChat. Важна последовательность: сначала компания заменяла CRM и автоматизировала процессы с жесткой детерминированной логикой, и лишь с 2025 года добавила LLM для разбора свободного текста.
Оба примера (по данным самих поставщиков решений) показывают зрелый подход: языковая модель не заменяет всю систему целиком, а встраивается в управляемый контур с маршрутизацией, поиском по проверенной базе (RAG) и участием операторов. При этом стоит помнить: технология RAG (поиск по внутренним документам, например через векторную БД Qdrant, сочетающую векторный поиск с фильтрами по метаданным) снижает риск выдумок модели, но сама по себе не гарантирует стопроцентную истинность ответа и не решает вопрос защиты ПДн, если итоговый промпт с данными клиента и найденными фрагментами отправляется во внешнее облако.
2. Записи звонков, транскрибация и речевая аналитика
Голос человека в сочетании с содержанием разговора (представление по имени, номер заказа, адрес, обсуждение условий сделки) в большинстве клиентских сценариев относится к персональным данным.
Компании используют речевые технологии как для контроля качества, так и для обучения сотрудников. Например, в июне 2024 года команда Сбера делилась опытом создания тренажера для клиентских менеджеров (публикация на Хабре от 26.06.2024): записи разговоров переводили в текст через SaluteSpeech, а затем анализировали работу с возражениями и формировали рекомендации с помощью GigaChat.
При проектировании такого конвейера важно различать два уровня сервисов и связанные с ними ограничения:
- Чистое распознавание речи (Speech-to-Text). Например, сервис Yandex SpeechKit (проверено 03.11.2026) преобразует аудио в текст через API, SDK или интерфейс AI Studio (синхронный режим рассчитан на одноканальное аудио до 30 секунд, асинхронный — на многоканальные записи до 4 часов). На этом этапе вы получаете только текстовую расшифровку, которая уже содержит персональные данные из диалога, но еще не дает аналитических выводов.
- Комплексная речевая аналитика. Специализированные решения, такие как Yandex SpeechSense (проверено 03.11.2026), объединяют распознавание речи, статистику диалога, поиск ключевых слов и генерацию резюме разговора с помощью YandexGPT Pro. Здесь важно методологическое и правовое ограничение (связанное в том числе со ст. 16 152-ФЗ): автоматическую сводку диалога или найденные ключевые слова нельзя без проверки человеком считать безусловным доказательством вины оператора, его эмоционального состояния или единственной причиной потери клиента.
3. Первичные документы и интеграция с 1С
В бухгалтерии и документообороте счета, накладные ТОРГ-12, акты, УПД и кассовые чеки часто содержат данные индивидуальных предпринимателей, подписантов и физических лиц.
Здесь не всегда нужно разрабатывать собственного LLM-агента и передавать документы в открытые текстовые модели:
- Для типовой первички существует штатный сервис 1С:Распознавание первичных документов (1С:РПД) (входящий в официальный каталог цифровых решений 1С, проверено 02.11.2026). Процесс построен безопасно: пользователь загружает сканы или фото, сервис распознает их, человек проверяет результат и затем создает документы в учетной базе.
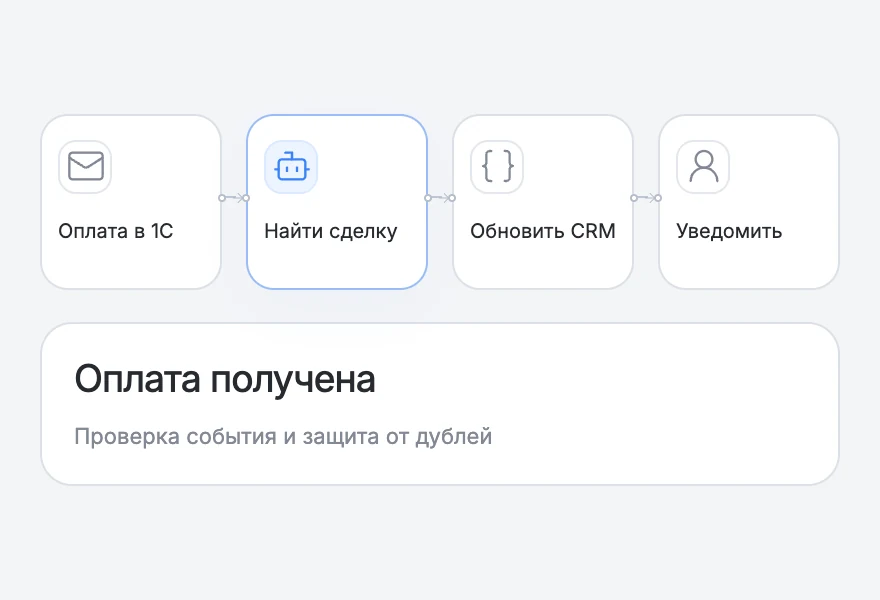
- Если же компании нужно подключить языковую модель к 1С для нестандартных задач (например, сверка сложных спецификаций или разбор входящих претензий), платформа 1С:Предприятие v8 поддерживает HTTP-сервисы (проверено 02.11.2026). Или используется протокол Model Context Protocol (MCP) (проверено 02.11.2026), связывающий хост, клиент и сервер через stdio или Streamable HTTP. В обоих случаях это лишь транспортный и архитектурный механизм: разработчику и безопасникам необходимо самостоятельно настроить права доступа, фильтрацию выгружаемых полей и решить, куда именно уходит HTTP-запрос — в облако или на внутренний сервер.
4. Автоматизация цепочек (n8n, Make) и корпоративные чат-боты
Частая точка утечки персональных данных за рубеж — не сама языковая модель, а связующий сервис автоматизации (оркестратор).
Если компания использует облачную версию Make (проверено 02.11.2026) или облачный тариф n8n (проверено 02.11.2026), чтобы забирать лиды из CRM и отправлять их даже в российскую нейросеть, сами данные транзитом проходят через зарубежные серверы оркестратора и сохраняются в истории выполнения сценариев (execution logs). Для соблюдения требований локализации при работе с ПДн оркестратор с открытым доступом к коду (например, n8n с fair-code лицензией, допускающий собственное размещение — self-hosted) разворачивают на российских серверах компании.
То же касается мессенджеров. При создании корпоративных или клиентских ботов на российских платформах, например в мессенджере MAX (проверено 02.11.2026), сам мессенджер требует подключения к платформе партнеров и верификации российского юрлица, ИП (до 5 ботов) или самозанятого резидента РФ (до 2 ботов). Но за то, куда бэкенд вашего бота пересылает сообщения пользователей для генерации ответа, отвечает уже ваша компания как оператор ПДн.
Сравнение архитектур: зарубежный API, российское облако или локальная LLM
Выбор инфраструктуры зависит от категории данных, требований внутренней службы информационной безопасности (ИБ) и бюджета.
| Критерий | Зарубежные облачные API | Российские облачные API (Yandex AI Studio, GigaChat) | Локальная LLM во внутреннем контуре (On-Premise / Private Cloud РФ) |
|---|---|---|---|
| Соблюдение ч. 5 ст. 18 152-ФЗ (локализация при сборе) | Высокий риск нарушения при передаче реальных ПДн граждан РФ. | Серверы находятся в РФ; при корректной настройке требование локализации выполняется. | Данные не покидают инфраструктуру компании (собственный сервер или российский ЦОД). |
| Трансграничная передача (ст. 12 152-ФЗ) | Возникает при каждом запросе с ПДн; требует предварительного уведомления РКН и оценки защиты. | Не возникает. | Не возникает. |
| Передача третьему лицу и поручение (ч. 3 ст. 6 152-ФЗ) | Требуется согласие субъекта на передачу и договор поручения (практически невозможно согласовать по стандартам РФ). | Требуется правовое основание (или согласие субъекта) и оформление поручения с облачным провайдером. | Передачи третьему лицу нет, если модель развернута на собственных мощностях и администрируется штатно. |
| Контроль над логами и коммерческой тайной | Зависит от политики иностранного вендора; высокий риск для ИБ. | Доступно отключение логирования в корпоративных тарифах, но данные проходят через контур провайдера. | Полный контроль: промпты, базы знаний (RAG) и веса модели изолированы внутри периметра. |
| Затраты на старте и эксплуатацию | Оплата за токены (сложности с прямой оплатой для юрлиц РФ). | Оплата по потреблению (pay-as-you-go) или пакеты без покупки своего GPU-оборудования. | Затраты на покупку или аренду серверов с GPU, настройку инференса и поддержку инженерами. |
Почему локальная LLM снимает часть вопросов, но не заменяет выполнение 152-ФЗ
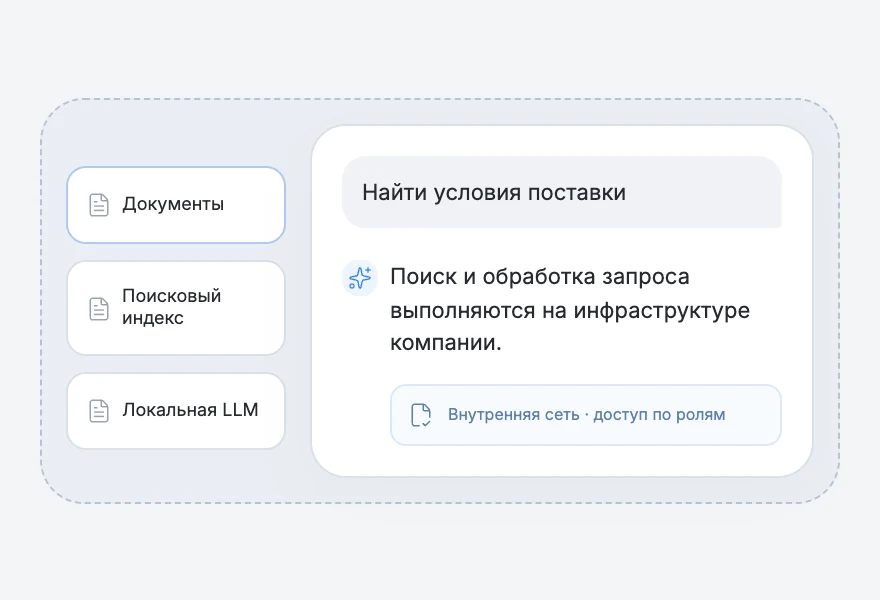
Переход на локальные языковые модели — самый надежный архитектурный способ исключить трансграничную передачу и не передавать клиентские базы внешним ИИ-провайдерам. Когда модель работает внутри вашего закрытого контура (например, через открытый движок инференса llama.cpp), вам не нужно брать у клиентов отдельное согласие на передачу их данных стороннему владельцу нейросети и заключать с ним договор поручения.
Однако локальный сервер сам по себе не означает автоматического соблюдения 152-ФЗ. Компания по-прежнему остается оператором персональных данных и обязана выполнять статьи 18.1 и 19 закона (текст 152-ФЗ, проверено 03.11.2026):
- издать локальные нормативные акты (политику обработки ПДн, регламенты доступа сотрудников к корпоративному ИИ-ассистенту);
- определить модели угроз и обеспечить техническую защиту сервера, на котором крутится LLM и векторная база данных;
- разграничить права доступа в RAG-системе, чтобы рядовой менеджер через запрос к внутреннему чат-боту не мог извлечь персональные данные сотрудников из папки отдела кадров или зарплатные ведомости;
- вести учет машинных носителей и логировать действия пользователей.
Экономика вопроса: сколько стоит обработка в российском облаке и на своих GPU
При выборе между российским облачным API и собственным сервером руководителю нужны конкретные цифры. Ниже приведены проверенные публичные тарифы российских платформ и расчеты для типовых сценариев (все цены указаны по данным официальных источников на начало ноября 2026 года, с НДС, если не оговорено иное; они не являются прайсом нашей компании).
Вариант 1. Российские облачные API (текст и речь)
Текстовые модели в Yandex AI Studio (официальный прайс, проверено 03.11.2026, синхронный режим, за 1000 токенов с НДС):
- Alice AI LLM Flash: вход — 0,1 ₽, выход — 0,2 ₽.
- YandexGPT Lite: вход — 0,2 ₽, выход — 0,2 ₽.
- YandexGPT Pro 5.1: вход — 0,8 ₽, выход — 0,8 ₽.
Условный расчет для текстовой обработки: допустим, ваша система за месяц обрабатывает поток обращений объемом 1 млн входных токенов и генерирует 200 тыс. выходных токенов через YandexGPT Lite. Расходы на саму генерацию составят: (1000 × 0,2 ₽) + (200 × 0,2 ₽) = 200 + 40 = 240 ₽ (без учета расходов на хранение, эмбеддинги, инфраструктуру и интеграцию).
Текстовые модели в GigaChat API (официальные тарифы для юрлиц, страница обновлена 07.10.2026, проверено 02.11.2026; общее руководство):
- Важное разделение по категориям клиентов: для новых клиентов с 1 сентября 2026 года подключение и оплата идут через платформу cloud.ru (актуальный тариф нового подключения необходимо запрашивать непосредственно у cloud.ru, переносить на них старые расценки нельзя).
- Для действующих клиентов «СалютДевайсы» / «Салют для Бизнеса» в синхронном режиме pay-as-you-go действуют тарифы за 1000 токенов с НДС: GigaChat Lite — 0,065 ₽, GigaChat Pro — 0,5 ₽, GigaChat Max — 0,65 ₽ (при фактическом использовании минимальная сумма составляет 600 ₽/месяц; если запросов не было, плата не взимается).
Распознавание и аналитика речи:
- В Yandex SpeechKit (проверено 03.11.2026) синхронное и потоковое распознавание стоит 0,1626 ₽ за 15 секунд одноканального аудио (с округлением вверх до 15 с). Стандартное асинхронное распознавание — 0,1515 ₽ за 15 секунд двухканального аудио (минимум 15 с, далее посекундно, число каналов округляется вверх до четного), а отложенное асинхронное — 0,0381 ₽ за 15 секунд.
- Условный расчет для транскрибации: чтобы расшифровать 1000 двухканальных записей звонков длительностью по 300 секунд (5 минут) в стандартном асинхронном режиме SpeechKit, потребуется:
1000 × (300 / 15) × 0,1515 ₽ = 3030 ₽только за перевод речи в текст (без LLM-аналитики и хранения). - Если же компании нужна готовая речевая аналитика Yandex SpeechSense (проверено 03.11.2026), она тарифицируется пакетами за календарный месяц с НДС: Basic (10 000 минут) — 45 000 ₽, Standard (30 000 минут) — 90 000 ₽, Advanced (100 000 минут) — 260 000 ₽ (включая рабочие места DataLens и консультации; при этом обработка AI-ассистентом распространяется на часть аудиозаписей согласно условиям выбранного пакета). Сопоставлять цену пакета аналитики напрямую с ценой голой расшифровки в SpeechKit некорректно — это продукты разного уровня.
Вариант 2. Инфраструктура для локальной LLM (свое железо или аренда GPU в РФ)
Если служба безопасности запрещает передавать данные во внешние API даже российских провайдеров, модель разворачивают на выделенных серверах с видеокартами.
Сначала оценивают потребность в видеопамяти (VRAM). При запуске через llama.cpp предварительный объем памяти только под веса модели можно прикинуть по формуле: число параметров × битность квантования / 8.
- Условный пример: для модели на 8 млрд параметров в 4-битном квантовании сами веса займут
8 млрд × 4 / 8 = 4 млрд байт(около 3,73 GiB). Но в реальной работе поверх этого объема потребуется память под KV-кеш (особенно при длинном контексте документа), служебные буферы и накладные расходы, а для MoE-архитектур в памяти нужно размещать все веса экспертов, а не только активные параметры. - Поэтому для комфортной работы компактных и средних корпоративных моделей ориентируются на карты с достаточным запасом VRAM — например, NVIDIA GeForce RTX 5090 оснащена 32 GB памяти GDDR7 (проверено 02.11.2026; само по себе наличие 32 GB не гарантирует запуск любой тяжелой LLM, архитектуру подбирают под задачу).
Если компания не готова сразу закупать серверы в собственность, инфраструктуру арендуют у российских хостинг-провайдеров (при условии оформления с ЦОД соответствующих договоров и разграничения доступа):
- По публичным данным российского провайдера FirstVDS (проверено 02.11.2026), стартовые предложения на серверы с видеокартами начинаются от 299 ₽/сутки за конфигурацию с vGPU L40S и от 1150 ₽/сутки за выделенный GPU Passthrough (в линейке представлены L4 / RTX 4090 / RTX 5090 / L40S; конкретная цена зависит от выбранной карты и объема памяти, минимальный срок оплаты — 1 сутки, бесплатного теста нет).
- Условный расчет на 30 суток: при неизменной стартовой посуточной ставке базовая аренда составит
299 × 30 = 8970 ₽для начального vGPU или1150 × 30 = 34 500 ₽для нижней границы GPU Passthrough (точную конфигурацию, наличие карт и налоговые условия необходимо проверять при заказе).
Стоимость самой разработки и интеграции также зависит от глубины задачи. Например, в публичном прайсе подрядчика Goose AI (проверено 02.11.2026) внедрение готового ИИ-агента из каталога со сценариями, интеграциями и тестированием оценивается в диапазоне 150 000–300 000 рублей (это предложение конкретного игрока рынка, а не среднерыночный норматив).
Чтобы рассчитать бюджет под вашу инфраструктуру и требования ИБ, ориентируйтесь на составляющие сметы ниже и актуальные условия на странице наших цен.
| Статья расходов при внедрении ИИ с учетом 152-ФЗ | От чего зависит стоимость |
|---|---|
| Предпроектный аудит потоков данных и архитектуры | Количество информационных систем (CRM, 1С, почта, телефония), категории ПДн и необходимость согласования со службой ИБ. |
| Выбор и подготовка инфраструктуры | Подключение российского облачного API (настройка прав, отключение логирования) либо разворачивание контура под локальные LLM на серверах заказчика или в ЦОД РФ. |
| Разработка конвейера данных и RAG | Настройка векторной базы (например, Qdrant), парсинг внутренних регламентов, настройка фильтров маскирования и ролевого доступа к документам. |
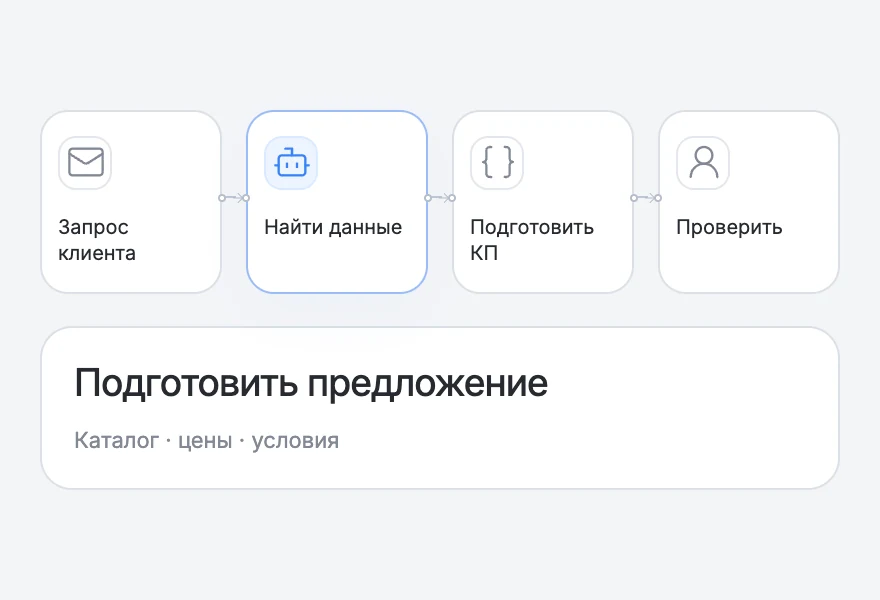
| Интеграция с прикладными системами | Написание коннекторов к 1С (через HTTP-сервисы), CRM, развертывание локального оркестратора (self-hosted n8n) и настройка проверок человеком (Human-in-the-Loop). |
| Тестирование качества и безопасности | Проверка точности ответов на контрольной выборке, тестирование защиты от промпт-инъекций и утечки чувствительных полей из базы знаний. |
Пошаговый алгоритм: как проверить проект перед запуском
Прежде чем открывать сотрудникам доступ к нейросети или запускать интеграцию в промышленную эксплуатацию, пройдите шесть обязательных шагов вместе с руководителем проекта, ИБ-специалистом и юристом:
- Проведите инвентаризацию данных в промптах. Выпишите, какие именно поля из CRM, 1С, почты или телефонных записей будут попадать в запрос к модели. Разделите задачи: для генерации описаний товаров персональные данные не нужны вовсе, а для разбора претензий они неизбежны.
- Проверьте локализацию всех узлов цепочки (ч. 5 ст. 18 152-ФЗ). Отследите маршрут данных от формы ввода до базы данных, оркестратора (исключите облачные зарубежные сценарии для ПДн) и самой языковой модели.
- Определитесь с контуром модели (облако РФ или On-Premise). Если допустимо использование российского облачного API, проверьте договор поручения на обработку ПДн (ч. 3 ст. 6 152-ФЗ), отключите сохранение логов на стороне провайдера и убедитесь в наличии правовых оснований для передачи (ст. 6, ст. 9 152-ФЗ). Если передача данных третьим лицам недопустима по политике ИБ или характеру сведений — выбирайте развертывание в собственном контуре.
- Настройте минимизацию и фильтрацию данных. Не передавайте в контекст модели всю карточку клиента из базы, если для классификации обращения нужен только текст вопроса и категория товара.
- Встройте человека в процесс принятия решений (ст. 16 152-ФЗ). Настройте систему так, чтобы в юридически значимых вопросах (найм, отказы по претензиям, финансовые условия) нейросеть формировала черновик или рекомендацию в интерфейсе сотрудника, а финальное действие подтверждал специалист.
- Оформите внутренние документы и меры защиты (ст. 18.1 и 19 152-ФЗ). Актуализируйте перечень информационных систем персональных данных (ИСПДн), регламент работы сотрудников с ИИ-инструментами и матрицу прав доступа к векторной базе знаний.
Важное примечание: Данная статья носит информационно-аналитический характер. Требования законодательства и практика его применения зависят от специфики вашей отрасли, категорий обрабатываемых данных и условий конкретных договоров. Перед запуском системы в промышленную эксплуатацию рекомендуем провести юридическую проверку вашего процесса, договоров с поставщиками, перечня получателей данных и актуальной редакции 152-ФЗ с профильными юристами.
Частые вопросы (FAQ)
Можно ли использовать зарубежные нейросети, если мы удаляем из текста фамилии клиентов?
Удаление одной фамилии редко является полноценным обезличиванием по смыслу статьи 3 152-ФЗ. Если оставшихся телефонов, ИНН физлица, электронной почты или сочетания деталей достаточно для определения человека без дополнительной информации, удаление фамилии не обеспечивает обезличивание. Для оценки результата нужно отдельно проверить оставленные сведения и доступную получателю информацию; переименование полей не является гарантией допустимости передачи. Затем проверяют требования к сбору данных по части 5 статьи 18 и к трансграничной передаче по статье 12.
Достаточно ли включить пункт об ИИ в общую политику конфиденциальности на сайте?
Нет. Во-первых, политика конфиденциальности — это публичный документ, определяющий общие правила оператора, но она не заменяет предметного согласия субъекта на передачу его данных конкретному третьему лицу (облачному провайдеру ИИ), если нет иного законного основания по ст. 6 152-ФЗ. Во-вторых, статья 9 152-ФЗ требует оформлять согласие на обработку ПДн отдельно от иных документов, которые подписывает или подтверждает человек.
Гарантирует ли переход на российское облачное API (YandexGPT, GigaChat) полное соблюдение 152-ФЗ?
Российский облачный сервис помогает выполнить требование о локализации баз данных на территории РФ (ч. 5 ст. 18) и избежать трансграничной передачи (ст. 12). Однако автоматического соблюдения всего закона это не дает: ваша компания обязана иметь законное основание для передачи данных провайдеру, заключить с ним корректное поручение на обработку ПДн (ч. 3 ст. 6), настроить защиту каналов связи и согласовать законные цели и сроки хранения логов.
Если мы поставим открытую нейросеть на свой сервер в офисе, 152-ФЗ нас больше не касается?
Установка локальной модели избавляет вас от передачи данных третьему лицу (внешнему ИИ-провайдеру) и от трансграничной передачи. Но вы остаетесь оператором персональных данных, поэтому обязаны соблюдать общие требования 152-ФЗ: иметь законные основания для обработки данных клиентов или сотрудников, соблюдать ограничения и предусмотренные законом исключения для исключительно автоматизированных решений с юридическими последствиями (ст. 16) и обеспечивать организационные и технические меры защиты самого сервера (ст. 18.1 и 19).
Нужна помощь с внедрением?
Если вашей компании нужно автоматизировать обработку документов, клиентских обращений или внутренней базы знаний без риска утечки персональных данных и коммерческой тайны во внешние сервисы, мы поможем спроектировать и развернуть защищенную архитектуру. Изучите подробности на странице услуги по внедрению локальных LLM в контуре компании — мы подберем модель под ваши задачи и оборудование, настроим RAG с разграничением прав доступа и интегрируем решение с 1С или CRM.