
Автоматизация бухгалтерии с помощью искусственного интеллекта начинается не с чат-бота, который якобы заменит главного бухгалтера, а с разбора папки «Входящие», где скапливаются десятки фото чеков и криво отсканированных УПД. На практике ИИ в бухгалтерии сегодня решает две совершенно разные группы задач: потоковое извлечение данных из первичных документов и работу с неструктурированным текстом — от сверки нестандартных формулировок в договорах до ответов сотрудникам по внутренним регламентам. Если компания пытается переложить на большую языковую модель (LLM) расчет налоговой базы или бесконтрольное проведение реализаций в учетной системе, проект заканчивается либо на этапе тестирования, либо при первой выездной проверке.
Чтобы внедрить ИИ для бухгалтерии с предсказуемым результатом, руководителю и финансовому директору нужно разделить жесткую алгоритмическую логику учета и вероятностные механизмы нейросетей. Там, где требуется извлечь реквизиты из типовых накладных, сопоставить номенклатуру со справочником и подготовить черновик документа в базе, лучше всего работает специализированное распознавание документов в связке с правилами проверки. А генеративные модели приносят пользу как ассистенты на предварительных этапах: классифицируют запросы в финансовую службу, ищут расхождения в карточках контрагентов или собирают справки по внутренним положениям компании.
Где в учетных процессах действительно нужен ИИ, а где достаточно обычных правил
В разговорах об автоматизации часто смешивают три разных технологических уровня: стандартные регламентные операции внутри учетной системы, оптическое распознавание с извлечением сущностей (OCR + классические и нейросетевые модели разметки) и генеративные языковые модели (LLM). Ошибка на старте — покупать сложную разработку с языковой моделью для задачи, которая решается штатным правилом обмена данными, или, наоборот, ждать от шаблонного сканера понимания свободной переписки с поставщиком.
В официальном каталоге цифровых решений «1С» к применению искусственного интеллекта в бухгалтерии относится, в частности, распознавание первичных документов по сканам и фотографиям (каталог 1С, данные проверены 02.11.2026). Но важно не путать этот класс задач с генеративным ИИ:
- Детерминированная автоматизация (без ИИ). Расчет амортизации, начисление зарплаты по табелю, зачет авансов по жестким правилам, загрузка банковских выписок в стандарте
1CClientBankExchangeи обмен электронными документами по форматам ФНС через операторов ЭДО. Здесь входные данные строго структурированы, а малейшее отклонение в логике недопустимо. Нейросети в этом контуре не нужны и опасны из-за риска галлюцинаций. - Специализированный ИИ для потоковой первички. Когда поставщики присылают бумажные акты, PDF без текстового слоя или фотографии кассовых чеков из командировок, системе нужно найти на листе табличную часть, ИНН, КПП, суммы с НДС и сопоставить их со справочниками базы. Для этого применяются готовые сервисы (например, «1С:Распознавание первичных документов») или кастомные конвейеры распознавания документов, если у бизнеса специфические бланки, многостраничные спецификации или сложная маршрутизация по центрам финансовой ответственности (ЦФО).
- Генеративный ИИ и LLM-агенты. Языковые модели подключают там, где форматы заранее не известны, а данные приходят в виде обычного человеческого текста: письма от контрагентов с объяснением расхождений по акту сверки, нетиповые формулировки предмета договора, заявки сотрудников в свободной форме на выдачу средств под отчет или поиск ответа в десятках внутренних регламентов и учетной политике.
Главное ограничение бухгалтерского контура: любая языковая модель и любой алгоритм компьютерного зрения работают с вероятностями. В бухгалтерском и налоговом учете нет понятия «счет-фактура заполнен правильно с вероятностью 94%». Поэтому архитектура здорового внедрения всегда строится по принципу Human-in-the-loop: ИИ готовит предзаполненный объект, подсвечивает сомнительные поля и берет на себя рутинный ввод, но финальную кнопку «Провести» нажимает бухгалтер.
Обработка первичных документов: как это работает на практике
Самый быстрый по отдаче участок для внедрения ИИ в бухгалтерии — ввод входящей первички. Пока доля бумажного документооборота и неформализованных сканов остается заметной, бухгалтеры тратят часы на перепечатывание номенклатуры, сверку ставок НДС и поиск дублей.
На примере официального сервиса «1С:Распознавание первичных документов» (1С:РПД) хорошо видна рабочая логика такого процесса (описание сервиса 1С:РПД, проверено 02.11.2026). Сервис поддерживает основные виды унифицированных и типовых форм:
- счета на оплату;
- товарные накладные ТОРГ-12;
- акты выполненных работ;
- счета-фактуры;
- универсальные передаточные и корректировочные документы (УПД и УКД);
- кассовые чеки.
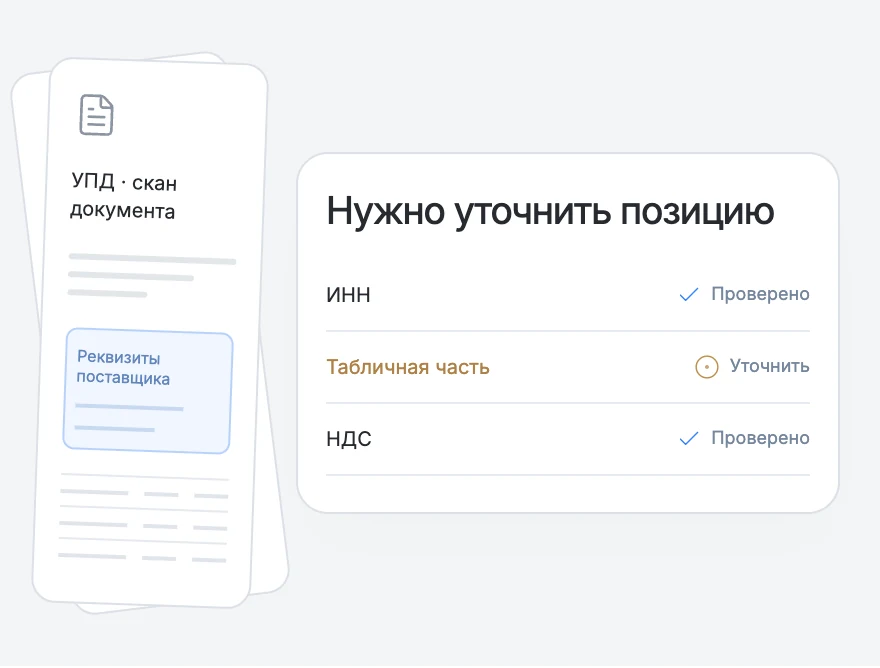
Рабочий цикл никогда не сводится к «загрузил архив и забыл». По регламенту сервиса процесс состоит из четырех шагов: загрузить файлы, распознать их, проверить результат и создать документы в учетной базе. Этап верификации человеком обязателен по трем причинам:
- Несовпадение номенклатуры. Поставщик продает «Кабель силовой ВВГнг(А)-LS 3х2.5», а в вашей базе эта же позиция заведена как «Кабель ВВГнг-LS 3*2,5 мм2 (бухта)». Алгоритм предложит наиболее близкий вариант или запомнит соответствие для конкретного ИНН после первой ручной привязки, но при появлении новой позиции выбор счета учета (например, 10.01 или 41.01) должен подтвердить специалист.
- Дефекты исходников. Штамп «Оплачено» поверх суммы НДС, выцветший термочек с АЗС, загнутый угол страницы или фотография под углом в плохом освещении снижают уверенность распознавания цифр. Хорошо настроенная система не придумывает недостающие разряды, а выделяет поле цветом для ручного контроля.
- Арифметический и логический контроль. Даже если каждый символ распознан верно, в самом документе поставщика может быть ошибка округления на копейку между ценой без НДС, суммой налога и итоговой стоимостью по строке.
Когда штатного сервиса недостаточно и нужна доработка
Коробочные решения отлично закрывают потребности компаний с типовым документооборотом в стандартных конфигурациях. Переход к индивидуальному конвейеру обработки обычно оправдан в четырех случаях:
- Документы поступают из десятка разрозненных каналов (почтовые ящики филиалов, мессенджеры прорабов на стройплощадках, личные кабинеты поставщиков) и требуют предварительной сортировки до попадания в бухгалтерскую базу.
- Внутри одного многостраничного PDF-файла свалены в кучу договор, спецификация, УПД, транспортная накладная и путевой лист — поток нужно сначала автоматически разделить по типам документов и комплектности.
- Требуется извлекать нестандартные реквизиты из пояснительных записок, отчетов комиссионеров или актов по сложным строительно-монтажным работам (КС-2, КС-3 с произвольными комментариями), чтобы привязать расходы к конкретным статьям управленческого бюджета и проектам.
- Перед созданием черновика в 1С нужно прогнать документ через внутренний комплаенс: сверить цены со спецификацией к рамочному договору, проверить наличие подписанного оригинала в архиве и статус контрагента.
Четыре рабочих сценария для генеративного ИИ и LLM в бухгалтерии
Если с табличными формами справляются специализированные модели распознавания, то большие языковые модели закрывают задачи, где раньше требовалось вчитываться в каждый абзац текста. Ниже приведены прикладные сценарии, которые можно реализовать без вмешательства в ядро расчета налогов.
| Сценарий в бухгалтерии и финслужбе | Что делает ИИ (LLM / RAG / OCR) | Где проходит граница ответственности человека |
|---|---|---|
| Сложный мэппинг номенклатуры и статей ДДС | По тексту назначения платежа или наименованию в накладной сопоставляет позицию с внутренним справочником компании и предлагает статью движения денежных средств (ДДС) и счет учета. | Бухгалтер подтверждает новые связки при первом появлении позиции и утверждает правила для нетиповых хозяйственных операций. |
| Предварительная проверка договоров и закрывающих актов | Сравнивает текст присланного акта с условиями договора: валюту, порядок расчетов, наличие обязательных оговорок, совпадение формулировки услуг с предметом сделки. | Юрист или старший бухгалтер принимает решение по выявленным расхождениям и согласует нестандартные формулировки. |
| Внутренняя база знаний по учетной политике и регламентам (RAG) | Отвечает сотрудникам в корпоративном чате на вопросы «как оформить суточные», «какой лимит по представительским расходам», «какие коды указывать в заявке на оплату», опираясь на приказы компании. | Главный бухгалтер утверждает актуальные редакции документов в базе знаний и разбирает нестандартные ситуации, которых нет в правилах. |
| Разбор писем от контрагентов и подготовка ответов по сверкам | Читает входящее письмо в свободной форме, определяет ИНН отправителя, номер договора и суть запроса («пришлите дубликат УПД за 3 квартал», «не сходится сальдо на сумму...»), формирует черновик задачи или ответа. | Бухгалтер на участке расчетов проверяет цифры в учетной базе и отправляет подписанный ответ или акт сверки. |
Почему база знаний (RAG) по бухгалтерским регламентам не дает 100% гарантии
Сценарий с внутренним ассистентом, который отвечает менеджерам и линейным бухгалтерам по корпоративным правилам, строится на архитектуре RAG (Retrieval-Augmented Generation — генерация, дополненная поиском). Чтобы модель не отвечала общими фразами из интернета, внутренние положения, инструкции по работе в 1С и учетную политику разбивают на фрагменты, преобразуют в векторные представления (эмбеддинги) и сохраняют в векторной базе данных.
Например, в официальной документации векторной СУБД Qdrant описано разделение на векторы, полезную нагрузку (payload), коллекции и индексы, а также возможность сочетать векторный поиск с жесткими фильтрами по метаданным и полнотекстовым поиском (документация Qdrant, проверено 02.11.2026). Для бухгалтерской базы знаний это критически важно: если в компании хранятся редакции учетной политики за 2024, 2025 и 2026 годы, одного семантического сходства векторов недостаточно — система выдаст устаревший лимит просто потому, что текст вопроса похож на старый приказ. Фильтрация по метаданным (дата действия документа, конкретное юрлицо холдинга, система налогообложения) позволяет отсечь неактуальные фрагменты еще до того, как они попадут в промпт языковой модели.
Но даже при грамотно настроенном гибридном поиске важно помнить базовое ограничение: наличие близкого по смыслу вектора не доказывает истинность и юридическую корректность ответа. RAG существенно снижает риск выдумок по сравнению с «голой» LLM, но если в исходных регламентах компании есть противоречия или вопрос требует комплексного толкования Налогового кодекса, модель может скомпилировать неверный вывод из двух правильных абзацев. В таких системах обязательно настраивают вывод прямых цитат и ссылок на пункт документа-источника, чтобы специалист мог проверить основание за несколько секунд.
Как связать ИИ-инструменты с 1С и корпоративными системами
Бухгалтер не будет копировать текст накладной в отдельное окно браузера, ждать ответа нейросети и вручную переносить результат обратно в 1С. Чтобы инструмент прижился, он должен работать бесшовно: документ упал на почту или в ЭДО — в базе появился черновик с комментарием от сервиса проверки.
Технически интеграция внешних ИИ-моделей с учетным контуром строится на нескольких проверенных компонентах:
- HTTP-сервисы и API на стороне 1С. Официальная платформа «1С:Предприятие» поддерживает создание произвольных HTTP-сервисов (документация платформы 1С, проверено 02.11.2026). Разработчик может задать шаблоны URL, настроить обработчики HTTP-методов и управлять телом, заголовками и кодами ответа. Важно понимать: это инструмент для реализации строго ограниченного прикладного API под конкретную задачу (например, принять JSON с распознанными строками счета и вернуть статус создания черновика), а не готовый универсальный коннектор любой языковой модели к любой конфигурации 1С.
- Оркестраторы рабочих процессов (n8n, Make). Чтобы не писать с нуля всю логику опроса почтовых ящиков, очередей, повторных попыток при сбоях сети и маршрутизации между OCR и LLM, компании часто используют платформы автоматизации процессов. Например, n8n совмещает классическую автоматизацию workflow и узлы для работы с ИИ, допускает как облачное использование, так и размещение на собственных серверах (self-hosted), и распространяется по лицензии fair-code — поэтому называть его полностью свободным ПО (open-source в строгом определении OSI) некорректно (документация n8n, проверено 02.11.2026). Альтернативный облачный вариант — Make, где сценарии собираются из визуальных модулей.
- Стандартизация контекста через MCP. В проектах, где ИИ-ассистенту нужно безопасно обращаться к нескольким внутренним источникам, все чаще применяют открытый стандарт Model Context Protocol (MCP). Архитектурно протокол связывает хост-приложение, клиент и серверы, которые предоставляют модели строго описанные инструменты (tools), ресурсы (resources) и шаблоны промптов (prompts) через транспорты
stdioилиStreamable HTTP(документация Model Context Protocol, проверено 02.11.2026). Сам по себе протокол MCP не создает волшебной готовой связки с 1С: инженерам все равно нужно написать реализацию MCP-сервера, настроить ролевые права доступа и описать конкретные методы прикладной системы, которые разрешено вызывать. - Корпоративные мессенджеры как интерфейс ввода. Когда линейным сотрудникам или водителям нужно быстро отправить фото чека, запросить справку или проверить статус оплаты счета, удобнее делать это через чат-бота. При выборе российской платформы MAX стоит учитывать правила площадки: согласно официальной инструкции, создание ботов требует подключения к платформе партнеров и верификации профиля организации, ИП или самозанятого — резидента РФ (документация MAX, проверено 02.11.2026). Организациям и ИП доступно создание до 5 ботов (самозанятым — до 2), а токен выпускается через веб-платформу или мини-приложение «MAX для бизнеса», поэтому механики из Telegram BotFather сюда напрямую не переносятся.
Если в финансовой службе или общем центре обслуживания (ОЦО) большой поток голосовых обращений от контрагентов и сотрудников по расчетам, к текстовому контуру иногда добавляют речевые технологии. В облачной платформе Yandex AI Studio для перевода голоса в текст используется сервис SpeechKit: по документации, синхронный режим рассчитан на короткие одноканальные записи до 30 секунд, а асинхронный позволяет обрабатывать многоканальные аудиофайлы длительностью до 4 часов (документация SpeechKit, проверено 02.11.2026). Для готовой речевой аналитики контакт-центров со статистикой диалогов, поиском ключевых слов и автоматическим резюме на базе YandexGPT Pro применяется отдельный сервис SpeechSense (документация SpeechSense, проверено 02.11.2026). При этом важно разделять техническую расшифровку или краткую сводку разговора и реальные управленческие выводы: автоматический тег в отчете не доказывает вину бухгалтера-расчетчика или причину конфликта с поставщиком без выборочной проверки записи руководителем.
Что показывает практика рынка: почему сначала наводят порядок в процессах
Ожидания бизнеса от ИИ часто завышены из-за рекламных заголовков, но реальный опыт крупных российских внедрений в смежных операционных и сервисных процессах подтверждает простое правило: языковые модели работают только поверх выстроенной базовой автоматизации.
Показателен публичный кейс в операционном обслуживании, о котором сообщила компания СберТех 23 сентября 2026 года: в Сбере внедрили мультиагентную систему обработки обращений на базе Platform V Flow и языковой модели GigaChat (сообщение СберТех, проверено 02.11.2026). Обратите внимание на последовательность шагов, описанную поставщиком решения: сначала команда провела замену CRM и автоматизировала процессы с детерминированной (жесткой) логикой, и только после этого, с 2025 года, в контур добавили LLM для работы со свободным текстом. Для бухгалтерии и финансовых служб этот архитектурный урок применим один в один: пытаться «прикрутить нейросеть» к хаосу в справочниках контрагентов и отсутствию регламентов согласования счетов бессмысленно. Сначала настраиваются жесткие маршруты и проверки по ИНН/договорам, а уже поверх них подключается языковая модель для разбора неструктурированных писем и комментариев.
Второй важный принцип — узкая фокусировка первого пилота (MVP). Еще в июне 2024 года команда Сбера в технической публикации на Habr рассказывала о создании тренажера для клиентских менеджеров, где записи разговоров транскрибировались через SaluteSpeech, а рекомендации формировал GigaChat (публикация в блоге Сбера на Habr, проверено 02.11.2026). Чтобы получить предсказуемое качество, разработчики на этапе MVP сознательно сузили задачу до одного конкретного сценария — работы с возражениями — и детально сравнивали разные подходы к построению промптов. Перенося этот инженерный подход на бухгалтерию, не стоит запускать проект с формулировкой «автоматизировать весь участок расчетов с поставщиками». Начните с одного узкого горлышка: например, только с проверки комплектности и извлечения табличной части из входящих УПД по товарным позициям одного склада.
Безопасность данных, 152-ФЗ и выбор между облаком и собственным сервером
В бухгалтерских документах содержится максимальная концентрация чувствительной информации: от условий коммерческих контрактов и сумм отгрузок до персональных данных физических лиц (ФИО, паспортные данные, ИНН, СНИЛС, реквизиты счетов и начисления в расчетных листках или договорах ГПХ). Поэтому вопрос «куда уходят сканы документов и тексты промптов» возникает у службы безопасности первым.
Что нужно учитывать по 152-ФЗ
При обработке документов, содержащих персональные данные сотрудников, подрядчиков-физлиц или индивидуальных предпринимателей, компания выступает оператором персональных данных и обязана соблюдать требования Федерального закона № 152-ФЗ «О персональных данных». В частности, статья 16 закона ограничивает принятие решений, порождающих юридические последствия в отношении субъекта персональных данных или иным образом затрагивающих его права и законные интересы, исключительно на основании автоматизированной обработки (за исключением случаев, предусмотренных законодательством или письменным согласием субъекта) (текст 152-ФЗ на сайте Росгвардии, проверено 02.11.2026).
На практике для финансовой и кадрово-расчетной службы из требований к защите данных следуют три практических вывода:
- Локальный сервер не равен автоматическому соблюдению закона. Даже если вы развернули открытую языковую модель в собственном закрытом контуре без доступа в интернет, это снимает риски передачи данных стороннему облачному провайдеру, но не отменяет обязанностей по оформлению правовых оснований обработки, разграничению прав доступа внутри компании, логированию действий и организационно-техническим мерам защиты.
- Обезличивание перед отправкой во внешний API. Если для классификации текста или разбора сложных таблиц используется облачный API российского провайдера, на шлюзе до отправки запроса разумно маскировать ФИО, паспортные данные и телефоны физлиц либо настраивать специальные режимы работы с данными. Например, в документации Yandex AI Studio предусмотрены отдельные правила хранения данных и возможность управления логированием запросов (документация Yandex AI Studio, проверено 02.11.2026).
- Никаких юридически значимых решений без человека. Автоматический отказ в выплате, удержание из вознаграждения или блокировка контрагента-физлица исключительно по вердикту нейросети без проверки ответственным специалистом создает прямые правовые и учетные риски. Конкретную архитектуру передачи данных и формулировки в локальных нормативных актах перед запуском в продакшен обязательно проверяет профильный юрист и специалист по информационной безопасности компании.
Когда нужен локальный контур (On-Premise / VPS с GPU)
Если служба безопасности категорически запрещает передавать тексты договоров и первичку во внешние облачные API даже российских вендоров (таких как Yandex AI Studio или GigaChat API от Сбера — документация GigaChat API, проверено 02.11.2026), модели разворачивают на собственных или арендованных выделенных серверах с графическими ускорителями.
Для локального инференса (запуска) открытых языковых моделей на C/C++ в индустрии широко используется открытый проект llama.cpp (репозиторий llama.cpp на GitHub, проверено 02.11.2026). Чтобы не покупать серверное оборудование вслепую, важно понимать, от чего зависит выбор видеокарты. Главный ограничитель для LLM — объем видеопамяти (VRAM).
Предварительную математическую оценку памяти, необходимой только для размещения весов модели, можно сделать по базовой формуле:
Условный расчетный пример: допустим, вы планируете локально запустить компактную языковую модель на 8 миллиардов параметров в 4-битном квантовании для классификации бухгалтерских писем.
- Считаем чистый вес: байт, что составляет около 3,73 GiB.
- Важное техническое уточнение: эта цифра учитывает только сами веса. В реальной работе поверх этого объема видеопамять расходуется на KV-кеш (контекстное окно диалога или длинный текст договора), служебные буферы вычислений и накладные расходы формата квантования. А если выбирается модель с архитектурой Mixture-of-Experts (MoE), в память нужно загружать веса всех экспертов, а не только число параметров, активных на один токен.
Поэтому для серьезных задач с длинным контекстом (например, подать на вход 15 страниц договора с приложениями) компании смотрят на ускорители с запасом видеопамяти. Например, по официальной спецификации NVIDIA, старшая потребительская видеокарта GeForce RTX 5090 оснащается 32 ГБ памяти GDDR7 (спецификация NVIDIA RTX 5090, проверено 02.11.2026), а в серверном сегменте применяются профессиональные карты вроде NVIDIA L40S. При этом сам объем памяти на коробке видеокарты не гарантирует определенную скорость генерации токенов в секунду на вашей конкретной задаче — производительность всегда проверяют нагрузочным тестированием на реальных длинах бухгалтерских документов.
Сколько стоит внедрение ИИ в бухгалтерии: из чего складывается бюджет
Бюджет проекта по автоматизации бухгалтерии с применением ИИ никогда не состоит из одной строки. Чтобы финансовый директор мог трезво оценить экономику, затраты нужно разделить на три части: расходные материалы инфраструктуры (токены облачных API или аренда GPU), лицензии на инструменты оркестрации и стоимость работы интегратора.
Ниже собраны проверенные публичные тарифы рыночных сервисов по состоянию на 2 ноября 2026 года. Это официальные прайсы конкретных инфраструктурных платформ и разработчиков, а не прайс-лист нашей компании и не «средняя температура по рынку».
1. Стоимость облачных языковых моделей (оплата за токены)
Если внутренний регламент безопасности позволяет работать с российскими облачными платформами по API, прямые затраты на генерацию текста оказываются весьма умеренными даже при тысячах документов в месяц.
- Yandex AI Studio (синхронный режим, цены в рублях с НДС за 1 000 токенов, проверено 02.11.2026 по официальному прайсу AI Studio):
Alice AI LLM Flash: входные токены — 0,1 ₽, выходные — 0,2 ₽.YandexGPT Lite: входные токены — 0,2 ₽, выходные — 0,2 ₽.YandexGPT Pro 5.1: входные токены — 0,8 ₽, выходные — 0,8 ₽.- Примечание: входной и выходной трафик тарифицируются раздельно; использование кеширования и встроенных инструментов рассчитывается по отдельным правилам платформы.
- GigaChat API для юридических лиц и ИП (проверено 02.11.2026 по официальной документации Сбера, страница обновлена 07.10.2026):
- Для новых клиентов (с 1 сентября 2026 года): подключение и оплата проходят через платформу
cloud.ru. Актуальный тариф для нового юрлица необходимо запрашивать и уточнять непосредственно уcloud.ru, так как автоматически переносить на новые контракты старую сетку нельзя. - Для действующих клиентов («СалютДевайсы» / «Салют для Бизнеса») по схеме pay-as-you-go в синхронном режиме за 1 000 токенов с НДС действуют ставки:
GigaChat Lite— 0,065 ₽,GigaChat Pro— 0,5 ₽,GigaChat Max— 0,65 ₽. Если сервис в течение месяца не использовался, плата не списывается; при наличии фактического трафика минимальная сумма платежа составляет 600 ₽ в месяц.
- Для новых клиентов (с 1 сентября 2026 года): подключение и оплата проходят через платформу
Условный расчет стоимости генерации на объем бухгалтерии:
Представим, что компания прогоняет через легкую модель YandexGPT Lite поток текстовых пояснений, писем контрагентов и карточек номенклатуры. За месяц общий объем промптов и извлеченного текста на входе составил 1 000 000 входных токенов, а ответы модели (JSON с классификацией и короткими резюме) заняли 200 000 выходных токенов.
- Считаем вход: .
- Считаем выход: .
- Итого за саму языковую генерацию: 240 ₽ с НДС в месяц. Эта цифра наглядно показывает, что в облачном сценарии сами токены редко становятся главной статьей расходов — основные деньги уходят на подготовку данных, OCR, серверную обвязку и поддержку интеграции с 1С.
2. Аренда серверов с GPU для изолированного контура
Если облачный API не подходит и требуется развернуть модель на выделенных мощностях в России, ориентироваться можно на публичные ставки хостинг-провайдеров.
По данным публичной витрины российского провайдера FirstVDS на 2 ноября 2026 года (тарифы FirstVDS GPU):
- Виртуальный сервер с разделяемым ускорителем vGPU L40S начинается от 299 ₽ в сутки.
- Серверы с прямым пробросом видеокарты (GPU Passthrough в линейке ускорителей L4 / RTX 4090 / RTX 5090 / L40S) начинаются от 1 150 ₽ в сутки (это нижняя граница входа в класс услуги; стоимость конкретной старшей карты, такой как RTX 5090 или L40S, объем выделенной видеопамяти, наличие свободных нод и налоговые условия зависят от выбранной конфигурации при заказе). Бесплатного тестового периода не предусмотрено, минимальный оплачиваемый срок аренды — 1 сутки.
Условный расчет на 30 суток: если перемножить стартовую посуточную ставку на 30 дней при условии ее неизменности, базовая точка входа составит от 8 970 ₽ за начальную конфигурацию с vGPU и от 34 500 ₽ за 30 суток за минимальную конфигурацию в линейке GPU Passthrough (это расчетная оценка по суточной ставке, а не фиксированный месячный абонемент).
3. Платформы оркестрации и связки сценариев
Если в архитектуре используются внешние визуальные оркестраторы, их модели тарификации кардинально отличаются друг от друга:
- n8n (облачная версия): по данным официальной страницы ценообразования (прайс n8n, проверено 02.11.2026), при условии годовой оплаты тариф
Starterсоставляет эквивалент 20 евро в месяц за 2 500 исполнений сценария (workflow executions), а тарифPro— 50 евро в месяц за 10 000 исполнений. Здесь списывается именно факт запуска всего сценария целиком, независимо от того, сколько внутренних шагов он прошел. - Make: по официальным правилам платформы (прайс Make, проверено 02.11.2026), единицей тарификации выступают кредиты (credits). Большинство действий отдельных модулей внутри сценария расходуют по 1 кредиту, а некоторые встроенные ИИ-функции могут списывать больше (исключения сделаны для модуля Router и ряда обработчиков ошибок). Поэтому один запуск бухгалтерского сценария из 10 шагов в Make израсходует не одну единицу, а сумму кредитов всех сработавших модулей. На бесплатном тарифе
Freeдоступно 1 000 кредитов в месяц.
Важная оговорка для российских компаний: для зарубежных облачных подписок (n8n Cloud, Make) перед закладыванием в бюджет необходимо отдельно проверять техническую и юридическую возможность оплаты с корпоративных счетов из РФ, а также требования вашего комплаенса к трансграничной передаче метаданных. На практике российский бизнес чаще выбирает self-hosted установку оркестраторов на собственных серверах внутри страны.
4. Разработка, настройка и внедрение под ключ
Покупка токенов или аренда сервера — это только «электричество». Основная часть стартового бюджета приходится на проектирование логики, настройку распознавания бланков, написание HTTP-сервисов в 1С и тестирование на реальных архивах бухгалтерии.
Для ориентира по рынку заказной настройки можно посмотреть на публичные предложения специализированных подрядчиков: например, в открытом прайсе студии Goose AI (проверено 02.11.2026 по странице цен Goose AI) внедрение готового ИИ-агента из каталога со сценариями, интеграциями и тестированием оценивается в диапазоне 150 000 – 300 000 рублей. Подчеркнем: это коммерческое предложение конкретного внешнего разработчика за типового агента, а не средняя стоимость любого бухгалтерского проекта по рынку.
В проектах, которые реализует команда ЭйАй Бизнес, итоговая смета зависит от состояния вашей учетной базы, разнообразия первичных документов и требований к безопасности. Ознакомиться с базовыми форматами работы можно на странице услуг и стоимости, а структуру затрат для подготовки бюджета внутри компании удобно оценивать по следующей матрице:
| Статья бюджета | Разовые затраты на старте (CAPEX / Setup) | Регулярные ежемесячные расходы (OPEX) | От чего зависит сумма в вашем проекте |
|---|---|---|---|
| Предпроектное обследование и разметка первички | Аудит видов документов (УПД, ТОРГ-12, нетиповые акты), сбор тестовой выборки, описание правил сопоставления со справочниками 1С. | Не требуется (только при появлении новых видов деятельности или новых юрлиц). | Количество поставщиков с нестандартными бланками и качество ведения текущих справочников номенклатуры и контрагентов. |
| Лицензии и инфраструктура ИИ (OCR + LLM) | Настройка облачного аккаунта или развертывание локального контура (при необходимости — покупка или аренда GPU-сервера). | Оплата пакетов страниц распознавания, расхода токенов облачных API или аренды VDS с GPU. | Суточный объем страниц входящих документов, длина текстов и требование службы безопасности (облако РФ или закрытый контур). |
| Интеграция с 1С и внешними каналами | Разработка расширения 1С и HTTP-сервисов, настройка забора файлов из почты, ЭДО или мессенджеров, настройка прав доступа. | Техническая поддержка при крупных обновлениях релиза конфигурации 1С или смене форматов обмена. | Типовая или сильно доработанная (неподдерживаемая) конфигурация 1С, количество баз и маршрутов согласования. |
| Обучение бухгалтеров и отладка промптов | Пилотный прогон на реальных документах за прошлый месяц, настройка подсветки расхождений, инструкции для сотрудников участка. | Выборочный контроль качества распознавания и актуализация векторной базы знаний при смене учетной политики. | Готовность команды менять привычный порядок ввода документов и четкость внутренних регламентов компании. |
Как запустить пилот в бухгалтерии и не парализовать текущий учет
Попытка перевести на новые рельсы сразу всю бухгалтерию в разгар сдачи квартальной отчетности гарантированно вызовет саботаж со стороны сотрудников. Рабочий план внедрения всегда двигается от простого к сложному без остановки текущих процессов:
- Зафиксируйте одну измеримую проблему. Не ставьте цель «внедрить искусственный интеллект». Сформулируйте задачу в терминах учетного процесса: например, «сократить время на перенос позиций из сканов товарных накладных от 30 основных поставщиков в 1С:Бухгалтерия» или «автоматизировать первичную проверку комплектности закрывающих документов от подрядчиков перед передачей на оплату».
- Соберите реальную грязную выборку. Возьмите 100–200 настоящих файлов за прошлый месяц — именно в том виде, в каком они реально приходят в компанию: с печатями поверх текста, рукописными пометками кладовщиков, нестандартными единицами измерения и сложными формулировками услуг. На «стерильных» примерах из презентаций любая система покажет отличный результат, а проблемы всплывут в первый же рабочий день.
- Выберите минимально достаточный инструмент. Если вся выборка состоит из типовых УПД, ТОРГ-12 и счетов, начните со специализированного сервиса распознавания для 1С. Если же нужно разбирать сложные многостраничные спецификации, сопоставлять нестандартные позиции со справочниками и анализировать сопроводительные письма, проектируйте комбинированный конвейер: качественный OCR + строгие алгоритмические проверки + LLM для неструктурированных полей.
- Оставьте за человеком финальный акцепт. Настройте интеграцию так, чтобы в 1С создавались непроведенные черновики документов или предзаполненные карточки задач с прикрепленным скан-образом. Бухгалтер должен на одном экране видеть исходный скан, распознанные поля и подсвеченные системой сомнения (например, «ставка НДС в строке не сходится с итогом» или «новый контрагент, проверьте реквизиты»).
- Оцените экономику после 3–4 недель параллельной работы. Замерьте, сколько времени уходит у специалиста на проверку черновика по сравнению с ручным вводом с нуля, какой процент строк требует ручной правки и сколько фактически потрачено на инфраструктуру и токены. Только после этого масштабируйте решение на другие участки учета.
Нужна помощь с внедрением?
Если ваша бухгалтерия перегружена ручным вводом накладных, актов, счетов и нетиповых документов, мы поможем спроектировать и внедрить надежный контур автоматизации без риска для налогового учета. Команда ЭйАй Бизнес настраивает потоковое распознавание документов, разрабатывает аккуратную интеграцию с вашей конфигурацией 1С через расширения и HTTP-сервисы и подбирает архитектуру — от облачных российских моделей до полностью изолированных решений на выделенных серверах. Перейдите на страницу услуги распознавания документов, чтобы обсудить вашу задачу и оценить пилот на тестовой выборке ваших бланков.