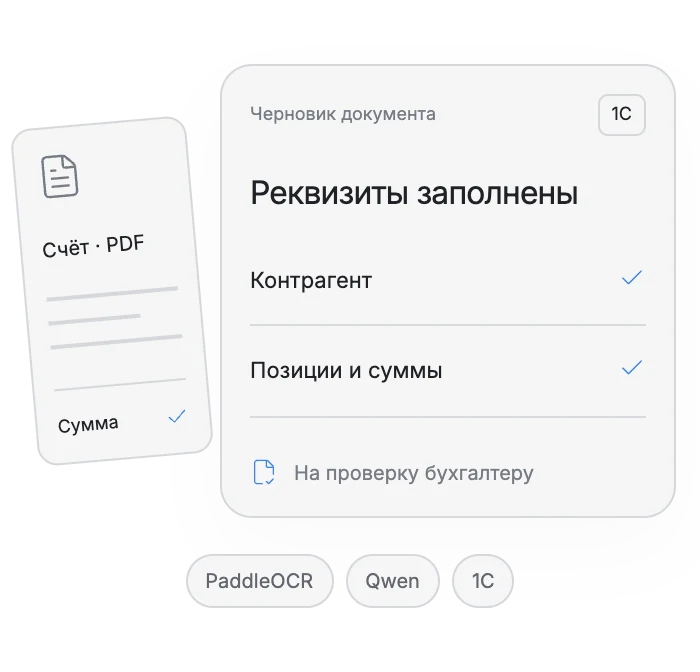
Задача
В оптовой компании бухгалтерия ежедневно обрабатывала десятки счетов, накладных и УПД. Документы приходили в PDF, Excel, сканах и фотографиях.
Сотрудники вручную переносили реквизиты, суммы и товарные позиции в 1С. На документ уходило несколько минут, а ошибки при переносе требовали дополнительных проверок.
Что сделали
- 01
Получение файлов
Система автоматически забирает документы из почты и подключённых источников.
- 02
Распознавание
Определяет тип документа и извлекает ИНН, реквизиты, даты, суммы, НДС и табличную часть.
- 03
Сопоставление с 1С
Находит контрагентов и номенклатуру, в том числе при отличиях в названиях товаров.
- 04
Проверка
Сверяет суммы, НДС и реквизиты, проверяет наличие дублей.
- 05
Черновик документа
Заполняет поля в 1С и прикрепляет исходный файл. Спорные позиции направляет бухгалтеру.
Как реализовали
- PaddleOCR · PP-StructureV3
- Qwen3-VL
- Python
- FastAPI
- n8n
- PostgreSQL
- 1С OData / HTTP API


PaddleOCR с PP-StructureV3 распознаёт текст и таблицы. Qwen3-VL помогает извлекать поля из документов с нестандартной структурой.
Python проверяет реквизиты и суммы, сопоставляет номенклатуру со справочниками 1С. FastAPI связывает обработку с остальными компонентами, n8n управляет получением файлов, PostgreSQL хранит данные процесса. Через OData/HTTP API в 1С создаются черновики.
Разные форматы документов
У поставщиков отличаются расположение реквизитов и названия товаров. Не все сканы хорошо читаются. Поэтому не привязывали распознавание к одному жёсткому шаблону: поля определяются по содержанию, затем проверяются по правилам.
Если ИНН не найден, суммы не сходятся или товар нельзя однозначно сопоставить, документ отправляется бухгалтеру. До подтверждения спорные данные не попадают в учёт автоматически.
Результат
- Файл проходит путь от получения до заполненного черновика в 1С.
- Исходный документ остаётся доступен для сверки с распознанными полями.
- Бухгалтер проверяет исключения и подтверждает документы вместо повторного ввода всех данных.
Цели пилота
Плановые показатели, а не подтверждённые результаты. Точность и экономию времени нужно измерить на документах компании.
- Плановый объём обработки в день
- 80 документов
- Целевая точность извлечения обязательных полей
- 96%
- Расчётный ресурс в день: 80 документов при сокращении обработки с 5 до 1 минуты
- ≈5 часов