
Когда компанию впервые знакомят с большими языковыми моделями, обычно возникает один и тот же вопрос: как заставить нейросеть отвечать строго по внутренним регламентам, прайс-листам и технической документации, а не придумывать условия от себя. Обычная языковая модель училась на текстах из интернета — она умеет связно формулировать мысли, но ничего не знает о ваших скидках за объём, правилах оформления возврата или редких артикулах на складе.
Чтобы не переобучать модель с нуля и не тратить недели на разметку датасетов при каждом изменении цен, используют архитектуру RAG. На практике именно так устроена рабочая база знаний для ИИ: при каждом вопросе система сначала ищет нужные абзацы в документах компании, передаёт их модели как справочный материал и просит сформулировать ответ строго по найденному тексту. Если вы планируете запускать корпоративного ИИ-ассистента для клиентской поддержки или внутренней справочной службы, разбор устройства RAG поможет заранее оценить объём работ по подготовке файлов, выбрать инфраструктуру и понять, где система действительно сэкономит время, а где потребуется контроль человека.
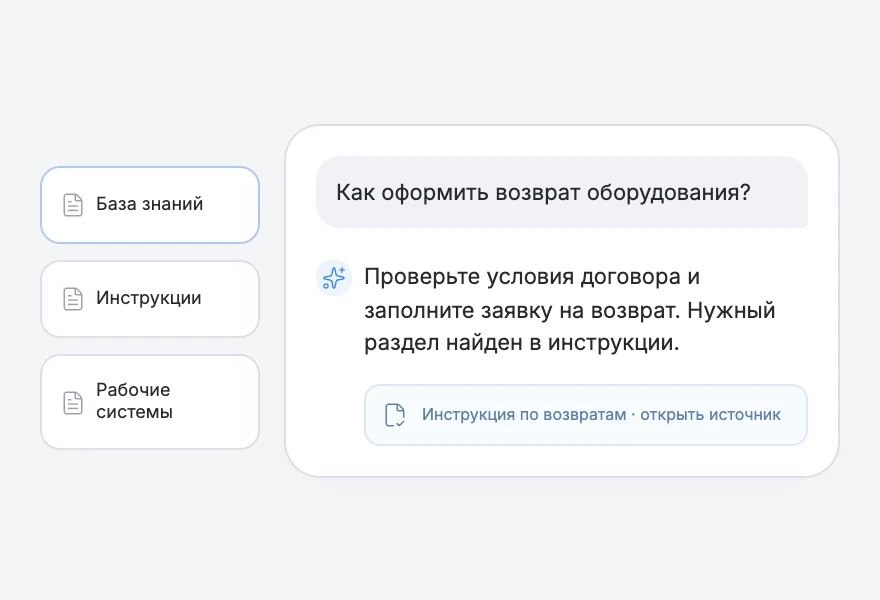
RAG добавляет к вопросу найденные фрагменты документов. Это помогает опираться на источники, но не гарантирует безошибочный ответ.
Что такое RAG простыми словами
Аббревиатура RAG расшифровывается как Retrieval-Augmented Generation — генерация, дополненная поиском. Если разобрать запрос «rag что это» без сложной математики, перед нами связка из двух знакомых инструментов: поискового движка по архиву документов и языковой модели, которая работает как внимательный редактор.
Чтобы понять разницу между стандартным чат-ботом и RAG-системой, представьте двух сотрудников, которым клиент задал сложный вопрос по гарантийному ремонту оборудования:
- Обычная языковая модель без доступа к базе ведёт себя как специалист, который отвечает исключительно по памяти. Если он точно помнит правило — ответ будет верным. Если подзабыл детали или правило поменялось на прошлой неделе — он может уверенным тоном назвать устаревший срок ремонта просто потому, что фраза звучит правдоподобно.
- RAG система действует как сотрудник, который перед ответом открывает актуальную папку с приказами, находит нужный пункт, сверяет дату документа и зачитывает клиенту точные условия, при необходимости давая ссылку на страницу регламента.
У руководителей нередко возникает встречный вопрос: зачем городить отдельный поиск, если современные модели позволяют загрузить в диалог сразу десятки страниц текста? В небольших задачах это действительно работает, но при создании промышленной системы бизнес быстро упирается в три ограничения:
- Экономика каждого запроса. Провайдеры облачных моделей считают стоимость во входных и выходных токенах (фрагментах слов). Если при каждом коротком вопросе клиента передавать в модель весь справочник компании на сотни страниц, бюджет на API улетит за считаные дни. Гораздо дешевле найти через поисковый индекс 3–4 нужных абзаца и отправить в нейросеть только их.
- Рассеивание внимания модели. Когда внутри одного запроса оказывается слишком много разнородного текста, модель хуже выделяет главное и может перепутать условия из соседних разделов — например, смешать правила доставки для оптовых и розничных покупателей.
- Скорость ответа и обновление данных. Поисковая база позволяет заменить один устаревший прайс-лист за пару секунд: достаточно переиндексировать конкретный файл. Дообучение (fine-tuning) самой нейросети для такой задачи не подходит — оно хорошо тренирует стиль общения или формат выдачи, но не гарантирует точного воспроизведения меняющихся цифр и фактов.
При этом важно сразу зафиксировать техническую границу: RAG заметно снижает риск выдумок (галлюцинаций), но сам по себе не даёт стопроцентной гарантии правильности ответа. Если в исходных документах есть противоречия или поиск подтянул не тот фрагмент, ассистент может ошибиться — ниже мы подробно разберём, какими инженерными методами это лечится.
Как работает RAG. Схема.
Работа любой базы знаний с ИИ делится на два независимых цикла: предварительную подготовку архива (индексацию), которая происходит в фоновом режиме при загрузке или обновлении файлов, и обработку живого вопроса пользователя в реальном времени.
ЭТАП 1. ПОДГОТОВКА БАЗЫ ЗНАНИЙ (ИНДЕКСАЦИЯ)
[Документы компании: PDF, DOCX, таблицы, статьи]
       │
       ▼
[Очистка текста и нарезка на смысловые фрагменты (чанки)]
       │
       ▼
[Модель эмбеддингов: перевод текста в числовые векторы]
       │
       ▼
[Векторная база данных: сохранение векторов + метаданных (payload)]


ЭТАП 2. ОТВЕТ НА ВОПРОС ПОЛЬЗОВАТЕЛЯ (РАБОЧИЙ ЦИКЛ)
[Вопрос сотрудника или клиента]
       │
       ▼
[Перевод вопроса в вектор и формирование фильтров]
       │
       ▼
[Гибридный поиск в базе: по смыслу (векторам) + по точным словам и фильтрам]
       │
       ▼
[Отбор 3–7 самых подходящих фрагментов документации]
       │
       ▼
[Сборка промпта: системная инструкция + найденные фрагменты + вопрос]
       │
       ▼
[Генерация ответа языковой моделью со ссылкой на источник]
Разберём ключевые узлы этой схемы, от которых напрямую зависит качество ответов и стоимость внедрения.
Нарезка на фрагменты (чанкинг) и метаданные
Языковая модель не читает документ целиком во время поиска. На этапе индексации длинные инструкции, договоры и регламенты разбиваются на небольшие смысловые отрезки — чанки (обычно от одного до нескольких абзацев). Чтобы при нарезке предложение не оборвалось на полуслове, соседние фрагменты сохраняют с небольшим нахлёстом (перекрытием).
К каждому такому отрезку обязательно прикрепляют метаданные: название документа, раздел, дату вступления в силу, уровень доступа или категорию товара. Без этих ярлыков система не поймёт, какой из двух приказов об отпусках — за 2023 или 2026 год — сейчас действует.
Эмбеддинги и векторная база данных
Обычный поиск по ключевым словам («Ctrl+F») плохо справляется с живой речью: покупатель может спросить «как вернуть деньги за сломанный товар», а в юридическом регламенте этот раздел называется «Порядок предъявления претензий по качеству и расторжения договора купли-продажи». Общих слов почти нет, но смысл один.
Чтобы компьютер уловил смысловую близость, специальная модель эмбеддингов (доступная, например, в составе Yandex AI Studio или GigaChat API) превращает каждый абзац текста в длинный массив чисел — вектор. Фразы со схожим смыслом получают близкие числовые координаты. Эти координаты вместе с исходным текстом складываются в специальное хранилище — векторную базу данных.
В качестве примера такой СУБД можно рассмотреть Qdrant. Как описано в официальной документации Qdrant (проверено 2 ноября 2026 года, источник: qdrant.tech/documentation/), система разделяет коллекции, индексы, сами числовые векторы и полезную нагрузку (payload — метаданные и исходный текст фрагмента). Что особенно важно для коммерческих баз знаний, документация предусматривает гибридный поиск: векторный поиск по смыслу сочетается с жёсткой фильтрацией по метаданным и классическим текстовым поиском. Это спасает в ситуациях, когда пользователю нужно найти точный артикул детали (АБВ-402-18), номер ГОСТа или фамилию ответственного — там, где размытый поиск по смыслу может подтянуть соседнюю модель оборудования.
При этом разработчики документации Qdrant справедливо отмечают фундаментальное свойство векторного поиска: наличие математически похожего вектора в базе означает лишь семантическую близость текстов, но само по себе не доказывает истинность или актуальность ответа.
Сборка контекста и генерация
Когда пользователь отправляет вопрос, система за доли секунды находит в базе несколько наиболее подходящих фрагментов, склеивает их со строгой системной инструкцией («Отвечай только на основе приведённого ниже контекста. Если информации нет, прямо скажи об этом») и отправляет в большую языковую модель. Модель читает отобранные куски и собирает из них связный, вежливый ответ на языке пользователя, прикладывая ссылку на конкретный пункт инструкции.
Зачем RAG бизнесу: ассистент для клиентов, внутренний помощник, поиск по регламентам
В отличие от универсальных чат-ботов «для всего», база знаний для ИИ приносит измеримую пользу там, где сотрудники или клиенты ежедневно тратят время на чтение однотипных многостраничных правил, каталогов и инструкций. Ниже приведены три типовых рабочих сценария (подчеркнём: это модельные прикладные сценарии, а не отчёты о конкретных завершённых проектах).
1. Ассистент первой линии для клиентов и дилеров
В компаниях со сложным ассортиментом — от строительных материалов и промышленного оборудования до медицинских или финансовых услуг — менеджеры первой линии перегружены вопросами по характеристикам, совместимости деталей, условиям доставки и возврата.
Если подключить RAG-систему к актуальным каталогам, паспортам изделий и правилам сервиса, бот сможет за несколько секунд подобрать нужную спецификацию или объяснить порядок оформления рекламации.
Для общения с клиентами компании часто выбирают мессенджеры. Если помимо привычных каналов рассматривается запуск бота в российской платформе MAX, важно учитывать её собственные правила. Согласно официальной инструкции для разработчиков MAX (проверено 2 ноября 2026 года, источник: dev.max.ru/docs/chatbots/bots-create/create), создание чат-ботов требует подключения к платформе партнёров и обязательной верификации профиля организации, индивидуального предпринимателя либо самозанятого (только для резидентов РФ). Организации и ИП могут создать до 5 ботов, самозанятые — до 2, а токен управления выдаётся через веб-платформу или мини-приложение «MAX для бизнеса». Привычные инструкции от Telegram BotFather сюда переносить нельзя — архитектуру интеграции закладывают под конкретную площадку.
2. Внутренний помощник для онбординга и поддержки сотрудников
В любой растущей компании накапливаются десятки папок с должностными инструкциями, правилами информационной безопасности, регламентами согласования договоров и оформления командировок. Новички неделями отвлекают опытных коллег вопросами «у кого подписать обходной лист» или «какой лимит суточных при поездке в регион», потому что искать ответ в сетевых папках долго и неудобно.
Внутренняя база знаний с ИИ позволяет задать вопрос обычным языком в корпоративном портале или мессенджере и сразу получить выжимку из действующего положения о командировках вместе с шаблоном заявления. При этом за счёт фильтрации метаданных (payload) система может разграничивать доступ: рядовой специалист увидит только общие правила компании, а руководитель отдела — регламенты премирования и кадрового резерва.
3. Умный поиск по техническим регламентам и связка с учётными системами
На производственных, логистических и сервисных предприятиях инженеры работают с сотнями страниц регламентов техобслуживания, кодами ошибок оборудования и отраслевыми стандартами. RAG помогает быстро находить причину неисправности по описанию симптомов или коду на дисплее станка.
Нередко бизнес хочет пойти дальше и объединить поиск по документам с действиями в учётных системах — например, чтобы ассистент не только ответил на вопрос по регламенту, но и проверил статус счёта в 1С или помог обработать входящую первичку. Здесь важно чётко разделять задачи RAG и специализированных инструментов:
- Распознавание и ввод первички. Если задача состоит в том, чтобы вводить в базу сканы счетов, накладных ТОРГ-12, актов, счетов-фактур, УПД, УКД или кассовых чеков, для этого не нужен RAG. В экосистеме 1С существует профильный сервис «1С:Распознавание первичных документов» (1С:РПД). Как указано в официальной документации сервиса (проверено 2 ноября 2026 года, источник:
v8.1c.ru/its/services/1s-raspoznavanie-pervichnykh-dokumentov/), рабочий процесс строится по строгой цепочке: загрузить файлы, распознать, проверить результат и создать документы в учётной базе. Обратите внимание: человек обязательно проверяет распознанные данные перед проведением в учёте — обещать полностью бесконтрольное автоматическое проведение первички нельзя. - Связка языковой модели с базой данных по протоколу MCP. Если же ИИ-ассистенту нужно параллельно с поиском по текстовой базе запрашивать живые остатки или статусы заказов из 1С или CRM, сегодня для этого всё чаще используют стандарт Model Context Protocol (MCP). Согласно архитектурной документации MCP (проверено 2 ноября 2026 года, источник:
modelcontextprotocol.io/docs/learn/architecture), протокол связывает приложение-хост (host), клиент (client) и сервер (server), используя транспорт stdio или Streamable HTTP, а серверы предоставляют модели инструменты (tools), ресурсы (resources) и шаблоны промптов (prompts). Однако важно понимать: сам по себе протокол MCP не является готовой «волшебной кнопкой» для интеграции с 1С. Чтобы связка заработала, разработчикам необходимо написать или настроить сам MCP-сервер, прописать методы прикладной системы и жёстко ограничить права доступа.
Для склейки всех этих шагов в единый процесс компании часто используют платформы оркестрации вроде n8n. Как отмечено в официальной документации docs.n8n.io (проверено 2 ноября 2026 года), n8n объединяет классическую автоматизацию процессов и работу с узлами ИИ, допускает как облачное использование, так и размещение на собственном сервере, и распространяется по fair-code лицензии (поэтому называть её полностью свободным ПО в юридическом смысле некорректно).
Как подготовить документы
Качество ответов любой RAG-системы на 80% определяется состоянием исходных файлов. Если загрузить в векторную базу данных папку со старыми сканами, противоречащими друг другу приказами и сложными Excel-таблицами с объединёнными ячейками, даже самая дорогая языковая модель выдаст кашу.
Перед тем как передавать архив разработчикам, документы необходимо провести через четыре этапа ревизии.
1. Аудит актуальности и устранение противоречий
В живой компании почти всегда есть «исторические наслоения»: базовый регламент продаж от 2022 года и три отдельных приказа генерального директора за 2024–2025 годы, которые меняют отдельные пункты этого регламента.
Человек, читая всю папку целиком, понимает, что более поздний приказ отменяет старый пункт. Поисковый алгоритм RAG работает иначе: на вопрос о правилах расчёта скидки он может вытащить абзац из документа 2022 года просто потому, что там формулировка точнее совпала с вопросом пользователя.
Что делать:
- Удалить из выборки черновики, недействующие редакции договоров и дубликаты.
- Если правила менялись отдельными приказами — собрать единую актуальную редакцию документа («консолидированный текст»), либо явно прописать в метаданных статус каждого файла и настроить жёсткую фильтрацию устаревших разделов при поиске.
2. Перевод сканов и графики в машиночитаемый вид
Файлы PDF бывают двух типов: текстовые (сохранённые напрямую из текстового редактора) и графические (отсканированные бумажные листы с печатями и подписями). Из обычного скана поисковый индекс не вытащит ни строчки, пока файл не пройдёт через систему оптического распознавания текста (OCR).
Отдельная головная боль — инструкции со скриншотами интерфейса или схемами, где вся суть написана на картинке или показана стрелочками («нажмите на красную кнопку в правом углу»). Векторный поиск по тексту эту картинку пропустит. Такие места нужно либо снабдить подробным текстовым описанием прямо под изображением, либо использовать на этапе парсинга мультимодальные модели, которые переводят содержимое схем в текст перед индексацией.
3. Приведение таблиц и прайс-листов к плоской структуре
Когда обычный алгоритм нарезает документ на фрагменты по 500–1000 символов, широкая таблица на три страницы неизбежно разрывается. В первый чанк попадает шапка таблицы («Наименование», «Базовый тариф», «Тариф Профи», «Лимит пользователей»), а в пятый чанк — строка | 15 000 руб. | 28 000 руб. | до 50 |. Когда модель получает этот пятый фрагмент без шапки, она не понимает, к какому тарифу и какому продукту относятся цифры.
Как подготовить таблицы для базы знаний:
- Избегать многоуровневых шапок и объединённых ячеек (merged cells) по вертикали и горизонтали.
- При программной нарезке (парсинге) дублировать названия столбцов в каждый чанк или преобразовывать строки таблицы в самодостаточные текстовые карточки вида: «Продукт: Модуль логистики. Базовый тариф: 15 000 руб. Тариф Профи: 28 000 руб. Лимит пользователей: до 50».
4. Самодостаточность разделов и расшифровка внутренних сокращений
Внутри отделов часто рождается свой сленг и локальные сокращения. В документе может быть написано: «При возникновении ошибки по п. 3 направить заявку в ОТиЗ по форме №2». Если этот абзац попадёт в контекст отдельно от начала документа, ни модель, ни новый сотрудник не поймут, о какой ошибке идёт речь и что такое ОТиЗ.
Хорошая практика при подготовке базы знаний — писать заголовки и абзацы так, чтобы каждый подраздел был понятен в отрыве от остальных страниц, а в начало базы добавлять краткий словарь внутренних терминов и аббревиатур компании.
Почему ассистент ошибается и как это лечится
Даже после базовой очистки документов на первых тестах RAG-ассистент может давать неточные или неполные ответы. Инженеры делят причины таких сбоев на две группы: ошибки поиска (не нашли нужный текст в базе) и ошибки генерации (нашли правильный текст, но модель неверно его интерпретировала).
В таблице ниже собраны типичные болезни корпоративных RAG-систем и проверенные способы их устранения.
| Как выглядит ошибка на практике | Почему это происходит внутри системы | Как это лечится при настройке |
|---|---|---|
| Ассистент путает артикулы, номера договоров или коды ошибок | Чистый векторный поиск ищет общую смысловую близость и плохо различает точные буквенно-цифровые индексы. | Включение гибридного поиска (сочетание векторного поиска с полнотекстовым поиском по точным совпадениям и фильтрам метаданных, как это реализовано, например, в Qdrant). |
| Бот уверенно называет прошлогодние цены или старые правила | В индекс попали старые версии файлов, либо они имеют такой же вес при поиске, как и свежие документы. | Очистка архива перед индексацией; добавление даты действия в метаданные (payload) и принудительная фильтрация неактуальных версий до отправки в LLM. |
| На сложный или разговорный вопрос система отвечает «Информации нет», хотя она есть в базе | Вопрос клиента сформулирован слишком коротко или бытовым языком, который слабо пересекается с юридическим языком документа. | Добавление шага переписывания запроса (Query Rewriting): вспомогательная быстрая модель сначала переводит вопрос пользователя на язык терминов компании, и только потом идёт поиск. |
| Ассистент отвечает частично, упуская важные оговорки со следующей страницы | Слишком мелкая нарезка чанков — основное правило попало в один фрагмент, а исключение со словом «Однако...» осталось в соседнем и не прошло по рейтингу. | Настройка перекрытия (overlap) между соседними чанками; переход к иерархической выборке, когда поиск идёт по коротким фрагментам, но в модель подгружается весь родительский подраздел. |
| Модель смешивает условия из разных тарифов или додумывает детали | В промпт попало слишком много «шумных» фрагментов (например, 15 кусков текста), а системная инструкция составлена слишком мягко. | Внедрение реранкера (Reranker) — отдельного алгоритма, который перепроверяет найденные куски и оставляет 3–5 самых точных; ужесточение системного промпта с требованием цитировать источник. |
Ещё один практический приём, который резко повышает доверие сотрудников к внутреннему помощнику — требовать от модели в каждом ответе выводить кликабельную ссылку на исходный файл и номер раздела. Даже если у специалиста возникнут сомнения в формулировке ИИ, он за три секунды откроет первоисточник и проверит норму глазами.
RAG на своём сервере
Когда речь заходит о загрузке в базу знаний коммерческих регламентов, договоров и внутренней кухни компании, служба безопасности закономерно ставит вопрос о сохранности данных. У бизнеса здесь есть два архитектурных пути: использовать защищённые облачные API российских провайдеров (например, Yandex AI Studio или GigaChat API, в документации которых предусмотрены корпоративные механизмы управления доступом и специальные правила хранения данных и отключения логирования) либо разворачивать весь контур — от векторной базы до самой языковой модели — на собственной инфраструктуре.
Подробно о выборе железа и открытых моделей для закрытого контура мы рассказываем в отдельном материале про локальные LLM на своём сервере. Здесь же разберём главные следствия такого решения именно для RAG-системы:
- Инфраструктура не ограничивается одной моделью. Чтобы RAG работал полностью автономно в закрытом контуре компании, на ваших серверах (или в изолированном частном облаке) нужно развернуть сразу несколько компонентов: векторную СУБД (например, локальный инстанс Qdrant), модель для создания эмбеддингов, реранкер, систему оркестрации (например, self-hosted версию n8n) и саму генеративную языковую модель на сервере с мощными видеокартами (GPU).
- Требования к администрированию. В облачном варианте доступность модели и обновления берёт на себя провайдер. На своём сервере следить за очередью запросов, нехваткой видеопамяти при длинных контекстах и резервным копированием векторных индексов должна внутренняя ИТ-команда или подрядчик по сопровождению.
- Юридический нюанс по персональным данным (152-ФЗ). В деловой среде популярен миф, будто установка локального сервера сама по себе автоматически решает все вопросы с законом № 152-ФЗ «О персональных данных». Это опасное заблуждение. Локальное размещение действительно исключает передачу данных стороннему облачному провайдеру LLM, но сам факт установки сервера в серверной комнате компании не означает автоматического соблюдения 152-ФЗ. Закон требует целого комплекса организационных и правовых мер: от модели угроз, категорирования, локальных нормативных актов и согласий субъектов до сертифицированных средств защиты информации (в зависимости от требуемого уровня защищённости) и строгого разграничения прав доступа внутри самой RAG-базы, чтобы один сотрудник не мог через запрос к боту вытащить персональные данные другого.
Поэтому на практике многие компании выбирают гибридный подход или проводят предварительное обезличивание (анонимизацию) документов перед их загрузкой в базу знаний: ведь для ответов по регламентам, инструкциям и прайс-листам фамилии, телефоны и паспортные данные клиентов в векторной базе вообще не нужны.
Сколько стоит
Бюджет на создание и поддержку базы знаний с ИИ никогда не сводится к одной цифре за подписку. Полная стоимость владения складывается из разовых работ по проектированию, подготовке документов и интеграции, а также ежемесячных регулярных платежей за инфраструктуру и обращение к моделям. Ознакомиться с форматами работы нашей команды и оставить заявку на расчёт под вашу задачу можно на странице услуги по созданию ИИ-ассистента для бизнеса, а состав работ и порядок оценки описаны в разделе цены.
Чтобы вы могли предметно ориентироваться в порядке цифр на рынке, разберём проверенные публичные тарифы на отдельные компоненты системы и посчитаем условный пример расхода токенов.
1. Стоимость генерации ответов по API (на примере Yandex AI Studio)
При использовании облачных российских моделей вы платите за объём текста, который система прочитала (входные токены — куда входят найденные в базе абзацы, системная инструкция и вопрос пользователя) и написала в ответ (выходные токены).
Согласно официальному прайс-листу Yandex AI Studio для синхронного режима (проверено 2 ноября 2026 года, источник: aistudio.yandex.ru/ru/docs/ai-studio/pricing, цены указаны в рублях с НДС за 1 000 токенов; правила тарификации кеша и встроенных инструментов рассчитываются отдельно):
- YandexGPT Lite: вход — 0,2 ₽ за 1 000 токенов; выход — 0,2 ₽ за 1 000 токенов.
- YandexGPT Pro 5.1: вход — 0,8 ₽ за 1 000 токенов; выход — 0,8 ₽ за 1 000 токенов.
- Alice AI LLM Flash: вход — 0,1 ₽ за 1 000 токенов; выход — 0,2 ₽ за 1 000 токенов.
(Примечание: эти расценки относятся только к проверенным тарифам Yandex AI Studio на указанную дату; их нельзя механически переносить на GigaChat или другие платформы, так как у каждого провайдера собственная сетка тарифов).
Условный расчёт затрат на генерацию:
Предположим, в вашей компании работает внутренний RAG-помощник на базе модели YandexGPT Lite. За месяц сотрудники задали ему серию вопросов, на обработку которых суммарно ушло 1 000 000 входных токенов (вопросы + подтянутые из базы фрагменты регламентов) и 200 000 выходных токенов (сгенерированные ответы бота).
Поскольку вход и выход считаются раздельно, получаем:
- Вход: .
- Выход: .
- Итого только за генерацию текста: .
Если для более сложных аналитических ответов переключить тот же объём трафика на модель YandexGPT Pro 5.1 (по 0,8 ₽ за тысячу входных и выходных токенов), аналогичный объём генерации составит .
Обратите внимание: эти 240 ₽ или 960 ₽ — плата только за саму генерацию ответа моделью. Сюда не входят расходы на генерацию эмбеддингов, аренду сервера под векторную базу данных, работу реранкера и техническую поддержку.
2. Расходы на оркестрацию и автоматизацию сценариев
Если RAG-ассистент строится на базе платформы автоматизации n8n, в смету закладывается либо стоимость поддержки собственного сервера (при self-hosted размещении), либо подписка на облачную версию сервиса.
По данным официальной страницы тарифов n8n (проверено 2 ноября 2026 года, источник: n8n.io/pricing/), при годовой оплате тариф Starter составляет эквивалент 20 евро в месяц (включает 2 500 исполнений сценариев — workflow executions), а тариф Pro — эквивалент 50 евро в месяц при оплате за год (за 10 000 исполнений сценариев). При этом важно учитывать три практических условия:
- Тарификация идёт именно по числу запусков сценария (workflow), а не по количеству шагов внутри него.
- Оплата внешних языковых моделей по API, инфраструктура хранения и работа интегратора в эту сумму не входят.
- Поскольку речь идёт о зарубежном сервисе с ценами в евро, российским компаниям перед выбором облачной версии необходимо отдельно проверять доступность легальных способов оплаты для юрлиц — на практике бизнес в РФ чаще выбирает развёртывание n8n на собственных российских серверах.
3. Рыночные ориентиры на внедрение под ключ и структура сметы
Стоимость работ подрядчика по сборке RAG-системы сильно зависит от состояния ваших документов и числа интеграций (нужно ли просто отвечать по десятку чистых PDF-инструкций в веб-чате или требуется двусторонняя связка с 1С, CRM и корпоративным порталом).
В качестве примера публичного рыночного предложения конкретного интегратора можно привести открытый прайс компании Goose AI (проверено 2 ноября 2026 года, источник: gooseai.ru/ceny/): стоимость готового ИИ-агента из каталога у этого подрядчика указана в диапазоне 150 000 – 300 000 рублей, куда входят настройка сценариев, интеграции и тестирование. Подчеркнём, что это публичная витрина одного конкретного игрока рынка, а не среднерыночная статистика и не прайс нашей компании; кроме того, сам по себе ценник внедрения не означает автоматической окупаемости без расчёта реальной нагрузки в вашем отделе.
Чтобы при запросе коммерческого предложения вы видели полную картину и не столкнулись со скрытыми платежами, сверяйте смету по следующей структуре расходов:
| Статья расходов | Разовый или регулярный платёж | От чего зависит сумма |
|---|---|---|
| Аудит, очистка и разметка документов | Разовый (плюс доработки при смене базы) | Объём архива, наличие старых сканов, сложных таблиц и противоречий в регламентах. |
| Настройка пайплайна индексации и векторной БД | Разовый | Выбор типа поиска (векторный или гибридный), сложность фильтрации по ролям и метаданным. |
| Интеграция с каналами и учётными системами | Разовый | Подключение к мессенджерам (Telegram, MAX), CRM, корпоративному порталу или 1С (в том числе разработка MCP-серверов). |
| Тестирование и отладка качества ( Борьба с ошибками) | Разовый (на старте) + итерации | Сборка контрольного списка из 50–100 реальных вопросов бизнеса, настройка промптов и реранкера. |
| Оплата API языковых моделей и эмбеддингов | Регулярный (ежемесячно) | Количество обращений пользователей, длина подгружаемых фрагментов и выбранный класс модели (Lite / Pro) либо аренда GPU при локальном запуске. |
| Хостинг и техническое сопровождение | Регулярный (ежемесячно) | Аренда серверов под векторную базу и оркестратор, мониторинг качества ответов и обновление индекса при выходе новых приказов. |
Нужна помощь с внедрением?
Если вы хотите перевести регламенты, прайс-листы или техническую документацию компании в формат работающей базы знаний, но не уверены, как лучше подготовить файлы и какую архитектуру выбрать — облачную или локальную, — давайте разберём вашу задачу на практике.
Мы проведём аудит ваших документов, покажем, как нарезать сложные таблицы без потери смысла, и рассчитаем прозрачную смету разработки и ежемесячного содержания системы. Переходите на страницу услуги по разработке и внедрению корпоративного ИИ-ассистента, чтобы ознакомиться с этапами работы и оставить заявку на консультацию.