
Обычно о внедрении нейросети задумываются, когда менеджеры тратят по полчаса на поиск условий доставки в десятках регламентов, а первая линия поддержки перегружена однотипными вопросами по статусу заказа. Если вам нужно понять, как сделать ИИ-ассистента для бизнеса, который не просто генерирует вежливые отписки, а сверяется с корпоративной базой знаний и учетной системой, начинать стоит не с выбора модели, а с архитектуры доступа к данным. Когда в компании нет ресурсов собирать такой контур с нуля, проще делегировать проектирование и внедрение ИИ-ассистента под ключ, но даже заказчику полезно понимать, из каких узлов состоит система и где возникают скрытые расходы.
Чем рабочий бизнес-ассистент отличается от обычного чат-бота
Кнопочный бот работает по жесткому дереву сценариев: шаг влево от заложенного алгоритма — и диалог заходит в тупик. Вторая крайность — подключить к корпоративному чату языковую модель (LLM) без ограничений. Она будет отвечать связно, но при нехватке фактов начнет придумывать несуществующие скидки, сроки гарантии или статьи договоров.
Полноценное создание ИИ-ассистента для бизнеса строится на сочетании трех механизмов:
- Поисковый контур (RAG — Retrieval-Augmented Generation). Перед тем как сформулировать ответ, система ищет релевантные фрагменты в ваших внутренних инструкциях, прайс-листах и регламентах, а затем передает их модели как контекст. Это заметно снижает риск выдумок, хотя и не дает стопроцентной гарантии правильности: если в исходных документах есть противоречия или поиск подтянул не тот абзац, модель может ошибиться.
- Вызов внешних инструментов (Function Calling / Tools). Ассистент не хранит в памяти остатки на складе. Понимая запрос клиента, он формирует структурированное обращение к API вашей CRM или ERP, получает актуальные цифры и переводит их на естественный язык.
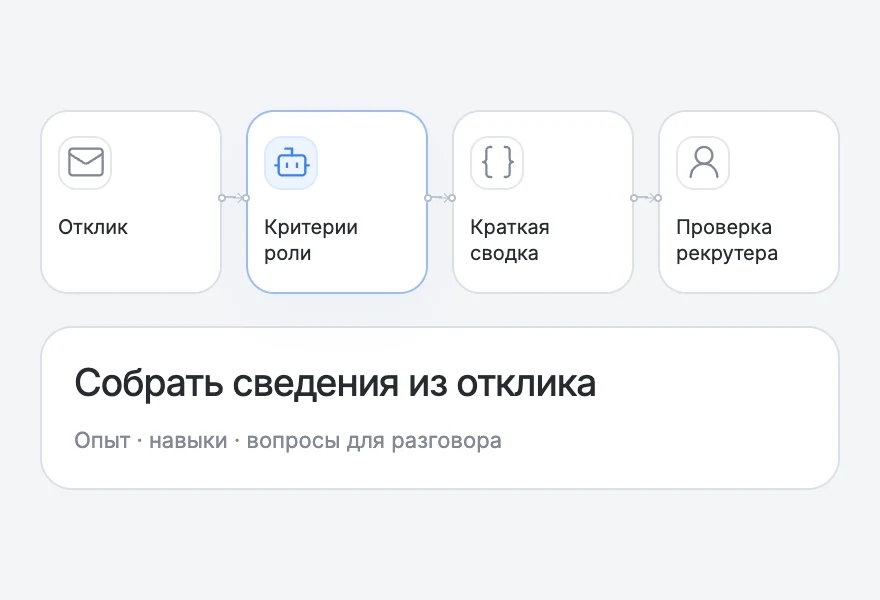
- Сценарная оркестрация. Логика, которая определяет, в какой момент достаточно ответить по справке, когда нужно запросить авторизацию, а когда — молча перевести диалог на живого сотрудника.
Типовые сценарии применения и их реальные ограничения
Ниже разобраны три прикладных сценария (это не отчеты о конкретных внедрениях, а архитектурные схемы с реальными инструментами и их техническими рамками).
Первая линия поддержки и навигация по регламентам
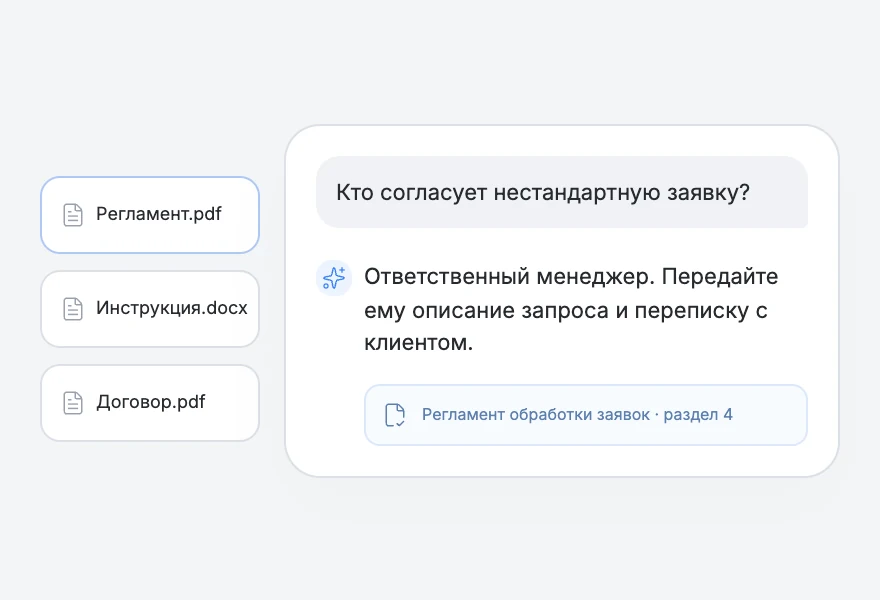
Сотрудник или клиент задает вопрос в корпоративном мессенджере, например в российском мессенджере MAX или во внутреннем веб-интерфейсе. Ассистент обращается к векторной базе данных. На практике для этого часто используют Qdrant: согласно официальной документации системы, она позволяет комбинировать векторный поиск по смыслу с текстовым поиском и жесткими фильтрами по метаданным (payload) — например, искать только среди действующих приказов конкретного департамента.
При этом важно помнить, что математическая близость векторов в базе еще не доказывает истинность ответа. Если в компании вовремя не удаляют старые редакции файлов, нейросеть уверенно процитирует архивный тариф.
Сверка данных и первичная документация в 1С
Частый запрос руководителей — «подключить нейросеть напрямую к 1С, чтобы она сама проводила накладные и отвечала клиентам по отгрузкам». На деле здесь работают два разных механизма.
Для чтения скан-копий и фото в экосистеме 1С существует профильный сервис «1С:Распознавание первичных документов» (1С:РПД). По официальному описанию платформы, он разбирает счета, накладные ТОРГ-12, акты, счета-фактуры, УПД, УКД и кассовые чеки. Но процесс устроен по схеме «загрузить — распознать — проверить результат — создать документ в базе». Полностью автоматическое проведение первички без участия бухгалтера обещать нельзя: финальную сверку распознанных позиций всегда делает человек.
Если же ИИ-ассистенту нужно узнать статус счета или остаток товара, используется механизм HTTP-сервисов платформы «1С:Предприятие». Разработчик прописывает шаблоны URL и обработчики методов, строго ограничивая, какие данные внешний скрипт может запросить или записать. Готового универсального коннектора, который безопасно подключит любую LLM к произвольной конфигурации 1С без участия программиста, не существует. Для стандартизации таких связок сейчас активно применяют протокол MCP (Model Context Protocol), который связывает приложение-хост, клиент и сервер, передавая модели доступные инструменты (tools), ресурсы и шаблоны промптов через транспорт stdio или Streamable HTTP. Однако сам по себе протокол интеграцию не создает — серверную часть и права доступа на стороне учетной системы все равно придется реализовывать вручную.
Обработка звонков и речевая аналитика
В контакт-центрах ассистенты помогают разбирать голосовые обращения. В экосистеме Yandex AI Studio для этого есть два разных инструмента, которые не стоит путать:
- Yandex SpeechKit отвечает за перевод речи в текст (STT) через API или SDK. Потоковый режим отдает промежуточные результаты прямо во время разговора. Для готовых записей есть синхронный режим (по документации рассчитан на одноканальное аудио до 30 секунд) и асинхронный — он принимает многоканальные файлы длительностью до 4 часов.
- Yandex SpeechSense — это уже надстройка для аналитики контакт-центров. Сервис считает статистику диалога, выделяет ключевые слова и строит краткое резюме разговора с помощью модели YandexGPT Pro.
Здесь проходит важная граница ответственности: ни чистая расшифровка из SpeechKit, ни автоматическая сводка из SpeechSense сами по себе не доказывают вину оператора, его эмоциональное состояние или реальную причину ухода клиента. Автоматика подсвечивает проблемные звонки по маркерам, но выводы о штрафных санкциях или смене скриптов требуют отдельной проверки контроля качества.
Из чего собирают ассистента: выбор технологического стека
Когда сценарий понятен, нужно выбрать, где именно будет работать языковая модель и какая система свяжет между собой мессенджеры, базы данных и API.
Облачные российские API против локального запуска (Self-hosted)
Для большинства бизнес-задач в РФ базовый выбор стоит между облачными платформами крупных провайдеров (Yandex AI Studio, GigaChat API от Сбера) и развертыванием открытых моделей на собственных или арендованных серверах с GPU.
Облачные платформы позволяют стартовать за пару дней без покупки оборудования.
- Yandex AI Studio предоставляет доступ к генеративным моделям, эмбеддингам, встроенному поиску по данным пользователя и MCP Hub. В настройках предусмотрены отдельные правила хранения данных и возможность отключить логирование запросов. По данным официального прайс-листа AI Studio (проверено 2 ноября 2026 года, синхронный режим, цены с НДС за 1 000 токенов): модель YandexGPT Lite стоит 0,2 ₽ на вход и 0,2 ₽ на выход; более тяжелая YandexGPT Pro 5.1 — 0,8 ₽ на вход и 0,8 ₽ на выход; быстрая Alice AI LLM Flash — 0,1 ₽ за входные и 0,2 ₽ за выходные токены. Кеширование и встроенные инструменты тарифицируются по отдельным правилам.
- GigaChat API умеет работать с текстом, файлами, изображениями, структурированными данными, эмбеддингами и вызовом функций (Function Calling). При расчете бюджета важно учитывать дату подключения (данные проверены 2 ноября 2026 года по документации со свежим обновлением от 7 октября): для действующих клиентов «СалютДевайсы» / «Салют для Бизнеса» в синхронном режиме pay-as-you-go действуют тарифы с НДС за 1 000 токенов — 0,065 ₽ для Lite, 0,5 ₽ для Pro и 0,65 ₽ для Max (при фактическом использовании минимальный платеж составляет 600 ₽ в месяц, при нулевом трафике плата не берется). Однако для всех новых юридических лиц и ИП, подключающихся с 1 сентября 2026 года, оплата идет через платформу cloud.ru — переносить на них архивные прямые тарифы нельзя, актуальные расценки нужно запрашивать напрямую у облачного провайдера.
Локальный запуск (On-premise / VPS с GPU) выбирают, когда внутренние политики безопасности запрещают передавать тексты запросов даже в российские облака. Для запуска моделей используют открытые движки инференса, например проект llama.cpp на C/C++.
Главное заблуждение здесь — считать, что для любой модели хватит одной мощной видеокарты, а сам факт локальной установки автоматически закрывает все требования 152-ФЗ «О персональных данных». Закон требует целого комплекса организационных и технических мер защиты, актов классификации и регламентов доступа, а не просто отказа от внешнего API.
С технической стороны объем видеопамяти (VRAM) нужно считать заранее. Предварительная математическая оценка памяти только под веса модели считается по формуле:
Условный расчет: если взять модель на 8 млрд параметров в 4-битном квантовании, получим байт, то есть около 3,73 GiB. Но это только «сухие» веса. На практике сверху добавляются KV-кеш (который растет вместе с длиной диалога и числом одновременных пользователей), служебные буферы и накладные расходы квантования. А для архитектур типа MoE (Mixture of Experts) в память приходится загружать все веса модели, а не только активные параметры. Поэтому даже флагманская потребительская карта GeForce RTX 5090, имеющая по официальной спецификации NVIDIA 32 GB памяти GDDR7, не гарантирует запуск любой крупной корпоративной модели с большим окном контекста.
Если покупать физический сервер нерентабельно, арендуют облачные GPU. Например, у российского провайдера FirstVDS (по публичным данным на 2 ноября 2026 года) стартовая цена конфигурации с разделяемым vGPU L40S начинается от 299 ₽ в сутки, а выделенный GPU Passthrough (в линейке представлены карты уровня L4, RTX 4090, RTX 5090, L40S — стоимость и доступность зависят от конкретной карты) — от 1 150 ₽ в сутки. При условном пересчете на 30 суток без изменения посуточной ставки это дает нижнюю планку от 8 970 ₽ и от 34 500 ₽ соответственно. Бесплатного тестового периода для таких серверов нет, минимальный шаг оплаты — одни сутки, а точный объем выделенной видеопамяти и налоги нужно проверять при сборке заказа.
Оркестраторы сценариев: n8n и Make
Чтобы не писать весь связующий код с нуля, инженеры используют low-code-платформы автоматизации.
| Критерий | n8n | Make |
|---|---|---|
| Модель размещения и лицензия | Облако или собственный сервер (Self-hosted). Лицензия fair-code (не является полностью свободным ПО в строгом юридическом смысле). | Облачный сервис. |
| Единица тарификации в облаке | Полное исполнение сценария (workflow execution) целиком, независимо от числа шагов внутри. | Кредиты (credits). Большинство действий модулей списывают 1 кредит, некоторые ИИ-функции — больше (маршрутизатор Router и ряд обработчиков ошибок — исключения). |
| Публичные ориентиры по цене (проверено 02.11.2026) | При годовой оплате: Starter — эквивалент 20 € в месяц за 2 500 исполнений; Pro — 50 € в месяц за 10 000 исполнений. | Есть бесплатный план на 1 000 кредитов в месяц. Точные цены платных тарифов требуют проверки в личном кабинете. |
| Особенности для РФ | Self-hosted версию можно развернуть на российском сервере. Оплата облачной версии с российских карт требует отдельной проверки. | Один сложный запуск ассистента может сжечь десятки кредитов. Доступность оплаты из РФ не гарантируется. |
Приравнивать один кредит Make к одному исполнению workflow в n8n нельзя: если ваш ассистент за одно обращение клиента делает пять запросов в базу, проверяет два условия и парсит документ, в n8n это спишет одно исполнение, а в Make — сумму кредитов за каждый задействованный модуль.
Пошаговый процесс: как сделать ИИ-ассистента для бизнеса
Разработка рабочей системы не начинается с написания промптов. Чтобы бот не превратился в дорогую игрушку, проект проводят через пять последовательных этапов. Если вы планируете пройти этот путь с внешней командой, изучите наш подход к разработке корпоративных ИИ-ассистентов, где каждый из этих шагов фиксируется в техническом задании.
1. Аудит процессов и сбор эталонного датасета
Сначала фиксируют узкую задачу: например, ответы по регламенту возврата брака или сбор первичных данных для КП. На этом этапе собирают 50–100 реальных исторических диалогов и пишут к ним идеальные ответы. Без такой проверочной выборки вы не сможете объективно оценить, стал ли ассистент работать лучше после смены модели или настроек поиска.
2. Подготовка базы знаний для RAG
Сырые многостраничные PDF-файлы и выгрузки с корпоративного портала нельзя просто свалить в одну папку. Документы очищают от дублей, размечают заголовками, режут на логические фрагменты (чанки), переводят в векторные представления (эмбеддинги) и загружают в поисковый движок вроде Qdrant, снабжая метаданными: датой актуализации, отделом и уровнем доступа.
3. Проектирование API и коннекторов
Настраивается транспорт между оркестратором, языковой моделью и учетными системами. Если ассистент должен работать с 1С, программист настраивает ограниченные HTTP-сервисы и права ролей. Если нужен интерфейс в российском мессенджере MAX, процедура отличается от привычного многим Telegram: согласно официальной документации платформы MAX, создать бота могут только резиденты РФ (юридические лица, ИП или самозанятые) после подключения к платформе партнеров и прохождения верификации профиля. При этом компаниям и ИП разрешено регистрировать до 5 ботов, а самозанятым — не более 2. Токен доступа выпускается через веб-платформу или мини-приложение «MAX для бизнеса».
4. Настройка системного промпта и защитных ограничений (Guardrails)
Модели задают четкую роль, тон общения и жесткие запреты: не отвечать на вопросы вне тематики компании, не обсуждать конкурентов, не обещать скидки, которых нет в подтянутом контексте, и при малейшем сомнении вызывать оператора.
5. Тестирование и вывод в эксплуатацию
Ассистента прогоняют по собранному на первом шаге датасету, проверяют устойчивость к провокационным запросам (промпт-инъекциям) и запускают сначала в режиме суфлера: нейросеть генерирует черновик ответа во внутреннем окне, а живой менеджер проверяет его и отправляет клиенту одной кнопкой. Только когда доля правок падает до приемлемого минимума, бота выпускают в прямой эфир.
Сколько стоит создание и поддержка ИИ-ассистента
Бюджет проекта всегда делится на две части: разовая разработка (или покупка готового решения с настройкой) и ежемесячные операционные расходы на инфраструктуру и токены.
На российском рынке встречаются пакетные предложения от профильных интеграторов. Например, по данным публичного прайс-листа компании Goose AI (проверено 2 ноября 2026 года), внедрение готового агента из каталога с настройкой сценариев, интеграциями и тестированием оценивается в диапазоне 150 000–300 000 рублей. Важно понимать, что это прайс конкретного подрядчика за типового агента, а не среднерыночная стоимость любой кастомной разработки и не гарантия быстрой окупаемости.
Чтобы вы могли прикинуть собственную экономику, разберем условный расчет расхода токенов в облаке. Допустим, ваш внутренний ассистент за месяц обработал объем запросов, который с учетом подтягиваемых из базы фрагментов документации составил 1 млн входных токенов, а сам сгенерировал ответов на 200 тыс. выходных токенов. Если считать строго по проверенному синхронному тарифу YandexGPT Lite (по 0,2 ₽ за 1 000 токенов на вход и на выход), чистая стоимость генерации составит:
- Вход:
- Выход:
- Итого за генерацию: 240 ₽ с НДС в месяц.
Если для той же задачи потребовалась более сложная модель YandexGPT Pro 5.1 (по 0,8 ₽ за 1 000 токенов в обе стороны), тот же объем обойдется в . Но в реальной смете к этим цифрам обязательно прибавляются затраты на векторизацию базы, серверы под оркестратор и техподдержку.
Из чего складывается полная смета проекта
| Статья расходов | Тип затрат | От чего зависит сумма |
|---|---|---|
| Проектирование, сборка RAG и интеграция с API / 1С | Разовые (CAPEX) | Количество источников данных, качество исходных документов, наличие готовых HTTP-сервисов в учетной системе. |
| Оплата токенов облачной LLM или речевых сервисов | Ежемесячные (OPEX) | Объем трафика, длина подгружаемых промптов, выбор модели (Lite против Pro/Max), использование STT/аналитики. |
| Аренда серверов (VPS под оркестратор / БД или GPU под локальную модель) | Ежемесячные / посуточные (OPEX) | При облачной LLM нужен обычный VPS под n8n и Qdrant; при локальном инференсе — аренда серверов с GPU (от сотен до тысяч рублей в сутки). |
| Сопровождение и актуализация базы знаний | Регулярные (OPEX) | Частота смены прайсов и регламентов, разбор логов с неудачными ответами, доработка промптов. |
Ознакомиться с нашими базовыми тарифами и форматами работы можно на странице цены на разработку и внедрение.
Частые вопросы руководителей перед стартом
Можно ли полностью заменить отдел поддержки или продаж ИИ-ассистентом? Нет, и ставить такую цель опасно для выручки. Ассистент эффективно снимает рутину: отвечает по справочнику, проверяет комплектацию, собирает первичные параметры заявки и маршрутизирует обращения. Нестандартные претензии, сложные переговоры и финальное утверждение первичных документов в учетной базе должны оставаться за людьми.
Что будет, если сотрудник спросит у бота данные, к которым у него нет допуска? Если права доступа не разграничены на уровне архитектуры поиска и API, бот выдаст закрытую информацию. Поэтому разграничение прав закладывают не в текстовый промпт (его легко обойти хитрым запросом), а на уровне жестких фильтров метаданных в базе Qdrant и авторизационных токенов при обращении к сервисам 1С.
Обязательно ли покупать дорогие видеокарты для запуска ассистента? Только если служба безопасности требует полного физического контура внутри компании. В остальных случаях на старте выгоднее использовать российские облачные API с отключенным логированием или арендовать мощности с посуточной тарификацией, чтобы проверить гипотезу без капитальных затрат на «железо».
Нужна помощь с внедрением?
Если вы хотите оценить, какие процессы в вашей компании реально автоматизировать без риска для клиентского сервиса, переходите на страницу услуги по созданию и интеграции ИИ-ассистента для бизнеса. Мы поможем разобрать вашу текущую инфраструктуру, подобрать стек под требования безопасности и составить прозрачную смету внедрения.